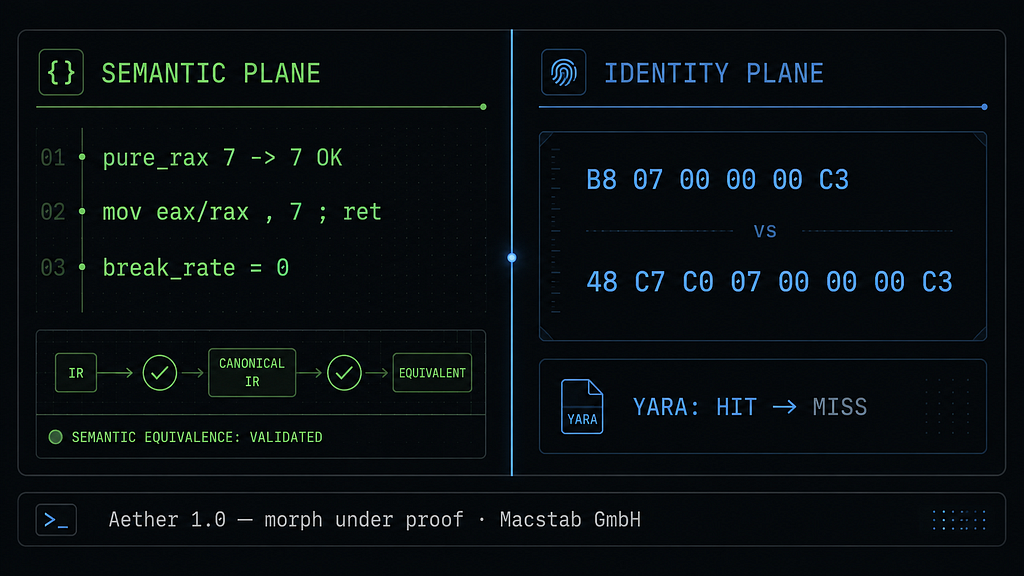
Codice sorgente su GitHub
Una firma fissa un solo punto nello spazio delle codifiche
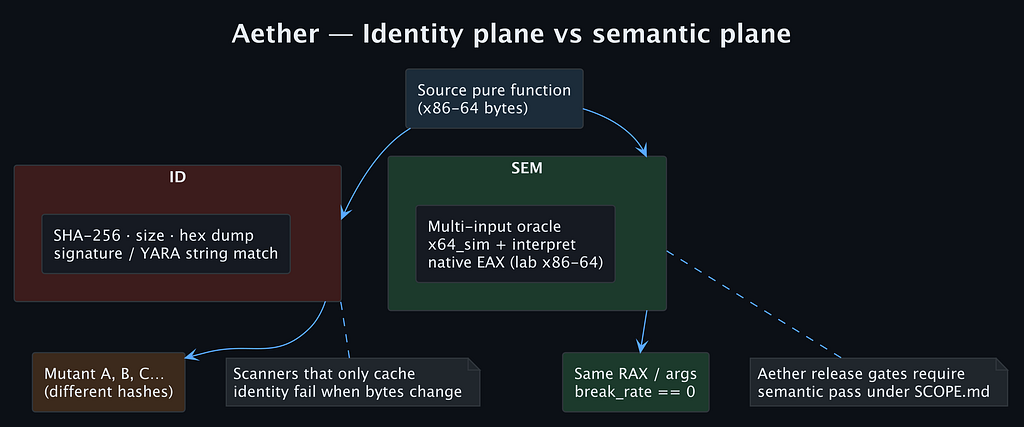
Una regola esadecimale YARA è un predicato sintattico su un buffer di byte. Ciò che cerca di individuare è un oggetto semantico, per esempio una funzione che restituisce 7. Tra questi due piani si trova la proprietà che definisce x86-64: una codifica a lunghezza variabile in cui la corrispondenza tra sequenze di byte ed effetti architetturali è fortemente molti-a-uno. Impostare RAX a 7 e ritornare ammette, a voler essere prudenti, più di una dozzina di codifiche legali.
Una firma fissa un punto in questo spazio. L'intero compito di un mutatore è spostarsi su un altro. Per questo l'ipotesi intuitiva — inserire un NOP, cambiare hash e dimensione e la regola di identità è aggirata — misura sul piano sbagliato. La domanda non è mai se alcuni byte si sono spostati. È se il punto esatto fissato dalla regola compare ancora da qualche parte nel buffer, e se la regola fissa un punto o una famiglia.
Si tratta di un'analisi di laboratorio su x86-64 per la valutazione autorizzata delle detection, con Aether 1.0.0 e Zydis v4.1.1 come implementazione di riferimento riproducibile. Non rivendica la semantica arbitraria di .text, la riscrittura binaria di uso generale né l'aggiramento di alcun prodotto di sicurezza.
Sei byte, un NOP, e la regola colpisce ancora
La funzione di test è di sei byte: B8 07 00 00 00 C3, cioè mov eax, 7; ret. La regola didattica corrisponde esattamente a quei byte, in modo contiguo. È una regola solo da laboratorio, non una firma di produzione; il suo valore sta nel rendere visibile il piano di identità.
La prima cattura SAFE con seed 42 ha prodotto 90 B8 07 00 00 00 C3: un NOP di un byte davanti all'originale invariato. L'hash è cambiato, la dimensione è cambiata, il valore di ritorno resta lo stesso e la regola continua a corrispondere, perché l'ago di sei byte è intatto un byte più avanti.
Il motivo è meccanico. YARA riduce il pattern ad atomi brevi, tipicamente sottostringhe fino a quattro byte come 07 00 00 00, li inserisce in un automa Aho-Corasick ed esegue il verificatore completo solo in corrispondenza degli atomi trovati. L'automa è indipendente dalla posizione, quindi uno spostamento di un byte non cambia nulla. Il corollario: la vera forza di una regola di identità è la qualità del suo atomo più raro, non la sua lunghezza. Usare caratteri jolly sull'immediato, come B8 ?? ?? ?? ?? C3, costringe YARA ad ancorarsi agli atomi di un byte B8 e C3, che saturano qualsiasi .text reale e trasformano la regola in una verifica lenta e poco precisa.
La conclusione che l'inserimento di riempitivo abbia aggirato la firma non è quindi accettabile senza testare la regola stessa. Questo esperimento ha misurato il padding, non la distruzione della regola.
{ B8 07 00 00 00 C3 } // contiguous identityUn cambio di codifica, e la regola manca il bersaglio
Il seed 5 segue un percorso diverso attraverso la stessa policy SAFE ed emette 48 C7 C0 07 00 00 00 C3. La stringa originale non compare più perché l'istruzione ha cambiato classe di codifica: un prefisso REX il cui bit W seleziona l'operando a 64 bit, il gruppo di opcode MOV C7 /0, un ModR/M a registro diretto che seleziona RAX, lo stesso immediato 7 e ret. Il risultato è di fatto mov rax, 7; ret.
L'affermazione ha un confine preciso. B8 estende con zeri il suo immediato a 32 bit in RAX, mentre REX.W + C7 /0 lo estende con segno. Per l'immediato positivo 7 entrambe le forme producono lo stesso valore a 64 bit. Il campo pure_rax di Aether, però, è un oracolo del valore di ritorno a 32 bit. Con un immediato come 0x80000000 le due forme differirebbero nei 32 bit superiori e l'oracolo non potrebbe accorgersene. L'affermazione semantica è volutamente limitata a questa forma con immediato positivo e al dominio di output a 32 bit dichiarato.
Nemmeno il seed da solo determina l'output; una cattura pubblicata deve indicare un processo nuovo, il primo morph con seed e la build esatta. Con questa disciplina, il confronto è pulito:
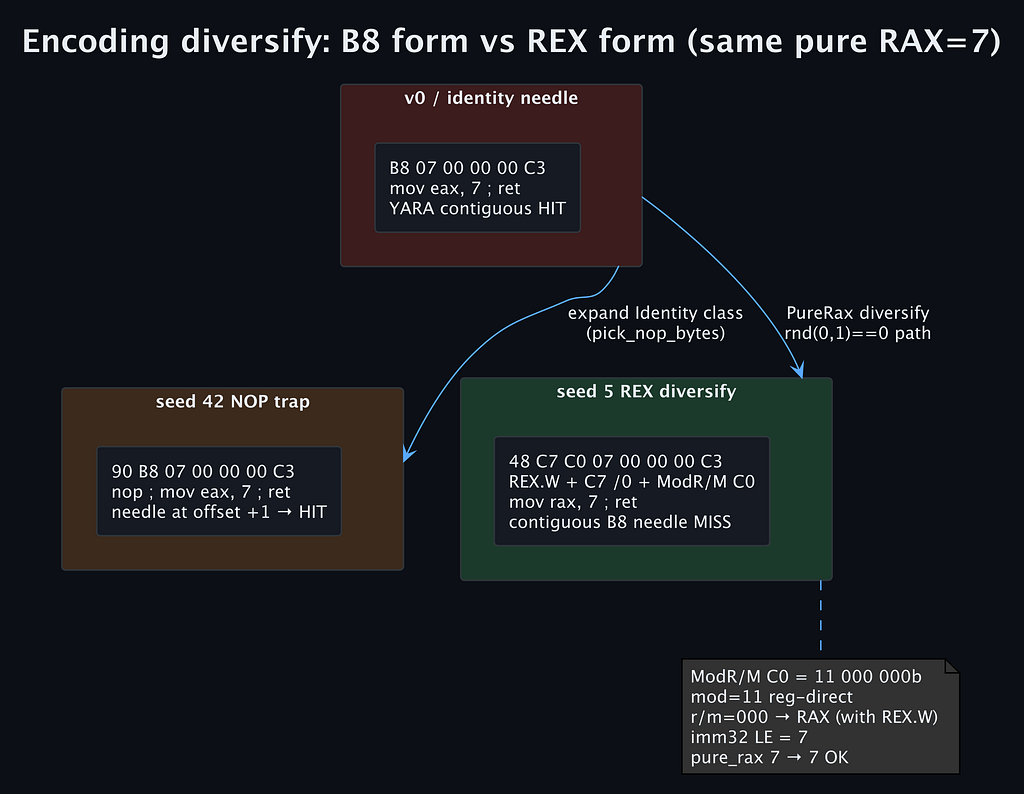
- Originale B8 … C3: regola di identità HIT, pure_rax 7
- Seed 42 (90 + originale): regola di identità HIT, pure_rax 7 → 7 OK
- Seed 5 (48 C7 C0 … C3): regola di identità MISS, pure_rax 7 → 7 OK
Cosa rende credibile il risultato
Questo non è un argomento a favore dell'impossibilità della detection. Una regola che riconosce entrambe le famiglie di codifica può ancora individuarle entrambe. È un argomento a dimostrazione che un singolo frammento di identità è incompleto.
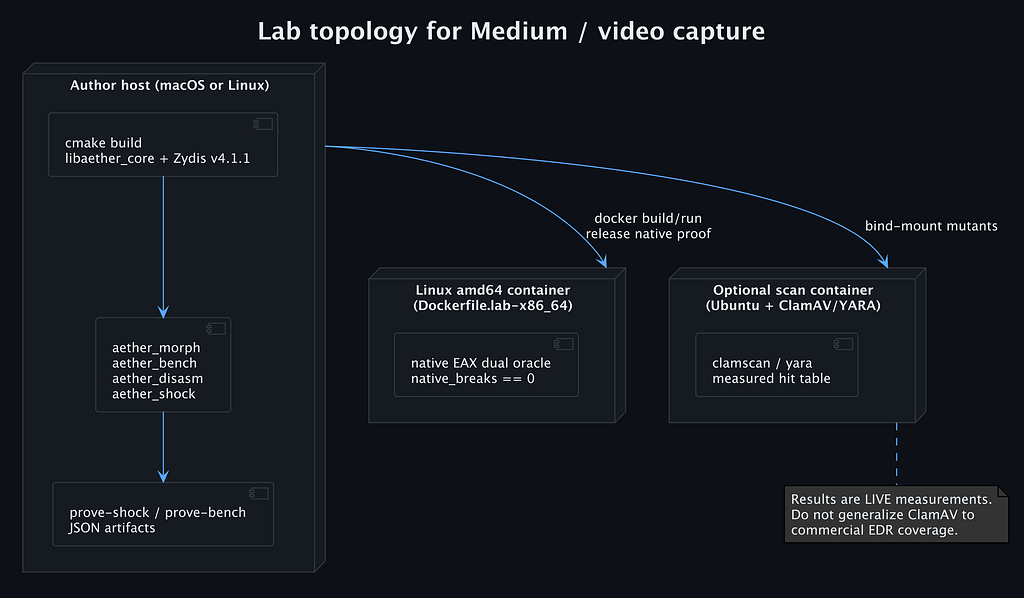
Aether decodifica ogni istruzione con Zydis e la classifica come Control, Memory, Identity, PureRax o un'altra classe; solo le istruzioni classificate entrano in un catalogo di sostituzioni delimitato semanticamente, e ret non viene mai diversificato come puro. I byte che Zydis non riesce a decodificare vengono mantenuti come opachi, così una decodifica errata riduce la superficie di trasformazione invece di inventare una riscrittura. Ogni output viene ridecodificato e verificato tramite un confronto puro del ritorno a 32 bit, un simulatore indipendente dall'host con coppie fisse di input multipli e, su x86-64 o nel laboratorio Docker amd64, l'esecuzione nativa. In modalità Lab o Industry una discrepanza pura porta a un fallimento chiuso.
Il benchmark del laboratorio dell'autore su Apple Silicon ha usato 5.096 voci di corpus (1.000 sintetiche e 4.096 da ELF). Riporta 10.192 morph riusciti, 5.020 controlli puri e 4.862 controlli nativi senza alcuna rottura, e il 94,89% di output unici secondo SHA-256. Sulla matrice mirata di 128 seed, la regola di identità di laboratorio ha colpito 30 volte (23,44%) e mancato 98 volte (76,56%), senza rotture pure. Sono dati di cattura per quella build e quell'host, non numeri permanenti del prodotto.
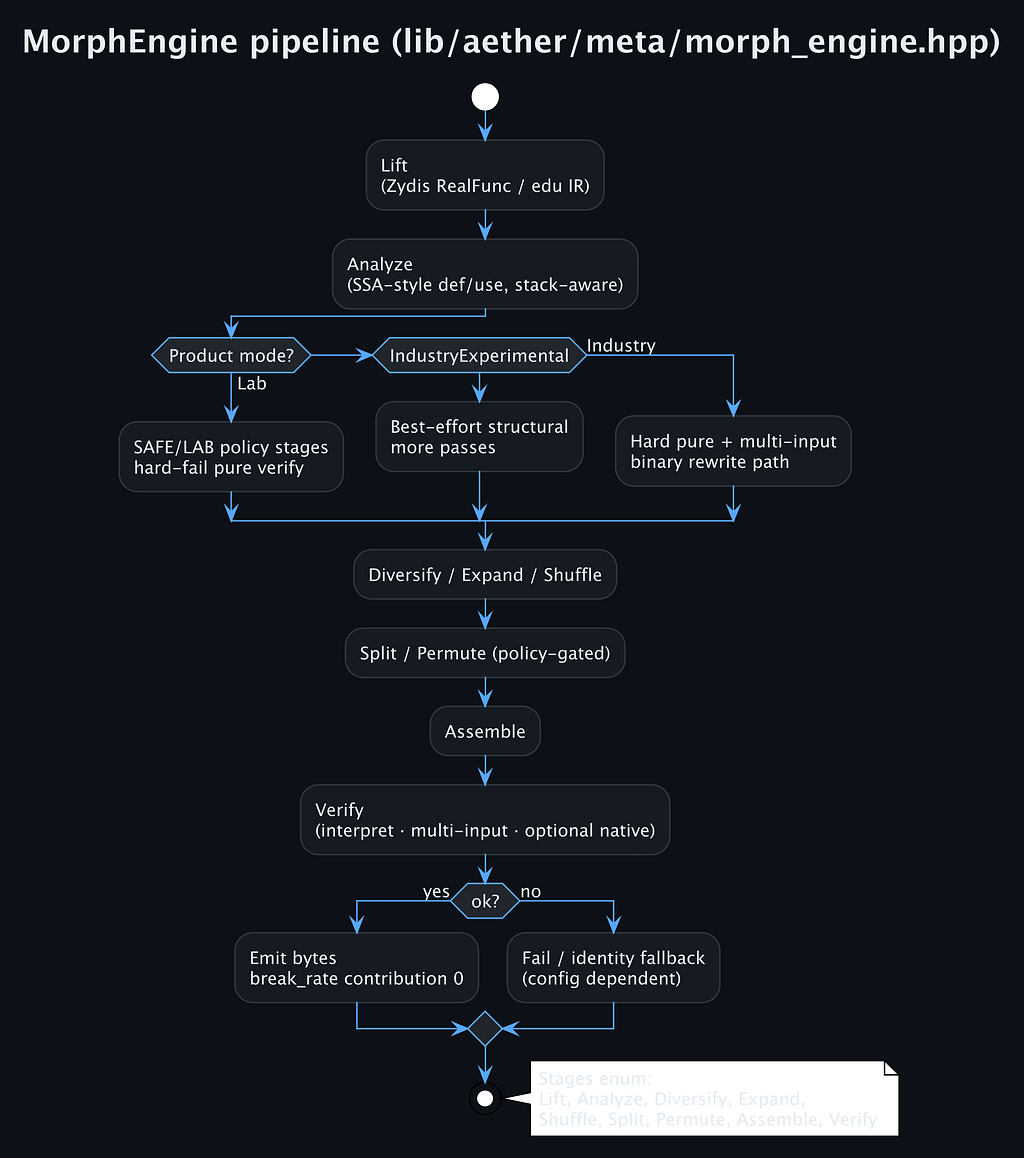
I livelli che devono concordare
La lezione non è usare più firme, e nemmeno che il morphing vince. È testare le regole sul piano che osservano davvero. L'esempio di sei byte attraversa cinque livelli, e trattarne uno qualsiasi come l'intero sistema è il modo in cui un dump di byte convincente diventa un'affermazione falsa. Una nuova decodifica strutturale non può dimostrare la semantica completa della macchina, un oracolo puro superato non può dimostrare che un EDR non abbia generato un allarme, e un MISS di YARA non può dimostrare che una codifica sia assente da tutte le famiglie di detection.
- Decodifica: quali byte e quale grafo di flusso di controllo abbiamo effettivamente decodificato?
- Analisi: questa trasformazione è consentita dal modello attuale?
- Lowering: i salti puntano ancora ai blocchi logici previsti?
- Oracolo: il contratto di output dichiarato è stato rispettato in questo dominio?
- Detection: quale osservabile è cambiato e quale sensore lo vede ancora?
Trasformare l'esperimento in CI per la detection
Lo schema utile: generare gemelli semantici legali all'interno di un dominio dichiarato in modo ristretto, eseguire la regola e l'oracolo, conservare le evidenze e poi riparare il sensore che ha fallito. Eseguite il job su almeno tre piani: l'oracolo semantico rifiuta le mutazioni che violano il contratto dichiarato, l'identità viene registrata come byte, dimensione e hash esatti, e il detector indicato viene eseguito con la sua regola esatta. Un'osservazione di ClamAV o di un EDR è una quarta misurazione separata, non un sostituto del risultato YARA.
Conservate il sorgente esatto della regola YARA di laboratorio, il report JSON del benchmark, i listati decodificati prima e dopo, e la versione e la data del detector. Indicate l'oracolo invece di scrivere validato: Apple Silicon può eseguire la simulazione ma non eseguire x86-64 in modo nativo, quindi usate il laboratorio Docker amd64 quando serve l'esecuzione su hardware.
Quando una regola fallisce, la correzione deve seguire il piano. Una regola di byte contigui può richiedere alternative per famiglia di codifica, contesto o un secondo segnale; una regola che copre sia B8 ?? … C3 sia 48 C7 C0 ?? … C3 può riconoscere entrambe le forme. Un detector di dimensione o entropia potrebbe già vedere l'espansione media di circa 2,19× e richiedere solo una calibrazione. Un sensore comportamentale va testato su superfici di esecuzione, allocazione, temporizzazione e memoria, anziché essere dedotto da un hash statico.
Key Takeaways
Un NOP non ha rotto la regola; una codifica equivalente sì. L'esperimento dimostra una debolezza di una regola di identità contigua, non un fallimento universale della detection, e vale solo all'interno del suo dominio dichiarato: una forma con immediato positivo, un oracolo di ritorno a 32 bit, una build specifica e una regola specifica.
La risposta giusta non è promettere invulnerabilità, ma rendere i presupposti di una regola eseguibili e coperti da test di regressione. Aether è pensato per un uso autorizzato in laboratorio secondo la Aether Research License. L'articolo completo su Medium contiene ogni misurazione e ogni avvertenza, e i documenti SCOPE, SCORECARD, LIBRARY e SECURITY nel repository vanno letti prima di considerare qualsiasi risultato come un'affermazione valida per il deployment.
Christian Schnapka
Macstab Engineering
Christian Schnapka sviluppa gli strumenti di ingegneria open source alla base di Macstab. Pubblica le versioni integrali di queste indagini su Medium, con ogni misurazione, ogni avvertenza e ogni risultato negativo inclusi.