Broncode op GitHub
Groen op elk dashboard, elke schrijfactie geweigerd
Uw Redis draait. Hij antwoordt op PING. De replica's zijn in sync, elk dashboard is groen — en al veertig minuten weigert hij elke schrijfactie.
Eén mislukte achtergrond-snapshot was genoeg. stop-writes-on-bgsave-error staat standaard op yes, dus vanaf dat moment weigert Redis alles wat de dataset wijzigt. Leesacties zien er nog steeds perfect uit. De master antwoordt op PING, het enige wat de health check van Sentinel raadpleegt, dus niets escaleert naar ODOWN en er wordt nooit een failover gestart.
En de code die u schreef voor de andere storing, die waarin een node echt sterft, heeft nog nooit gedraaid. Dat eerlijk oefenen vraagt één master, twee replica's, drie Sentinels, een correct quorum, geconvergeerde replicatie en een kill op precies het juiste moment. Dus wordt de cache gemockt, en ziet uw clientbibliotheek haar eerste +switch-master om 03:14 in productie.
macstab-chaos-redis, de derde laag van de Macstab Chaos Stack, neemt dat excuus weg. Daaronder liggen zes C99 LD_PRELOAD-bibliotheken en een JVM-bytecodeagent. Deze laag levert wat geen van beide kan: een productiegetrouwe topologie om fouten in te injecteren.
Eén annotatie in plaats van negentig regels
Na de dependency is één annotatie op klasseniveau de volledige setup. @RedisStandalone geeft u een echte Redis 7.4 op een willekeurige poort. @RedisSentinel geeft u één master, twee replica's en drie Sentinels met quorum 2, op hun eigen privé-Dockernetwerk. Geen @Testcontainers, geen statisch containerveld, geen @DynamicPropertySource, geen @AfterAll die u wilde schrijven maar nooit schreef. Handles zoals SentinelCluster komen binnen als parameters van de testmethode.
Het handgeschreven Sentinel-equivalent telt zo'n negentig regels en draagt kennis die de code nergens uitspreekt: één specifieke logregel is het enige bewijs dat een replica klaar is met synchroniseren, Sentinel moet een IP krijgen in plaats van een alias, en 2 000 moet de standaardwaarde van 30 000 vervangen, anders kan geen enkele assertie ooit afronden. Verwijder er één en de tests compileren nog steeds. Ze beginnen alleen te liegen. Met de annotatie zit die kennis in het framework, één keer geschreven en gedekt door tests. Opruimen loopt via de CloseableResource-store van JUnit, met de Ryuk-reaper van Testcontainers als onafhankelijk tweede pad.
// Gradle
testImplementation 'com.macstab.chaos:macstab-chaos-redis:1.0.0'

@RedisSentinel                       // 1 master + 2 replicas + 3 sentinels, quorum 2
class FailoverTest { }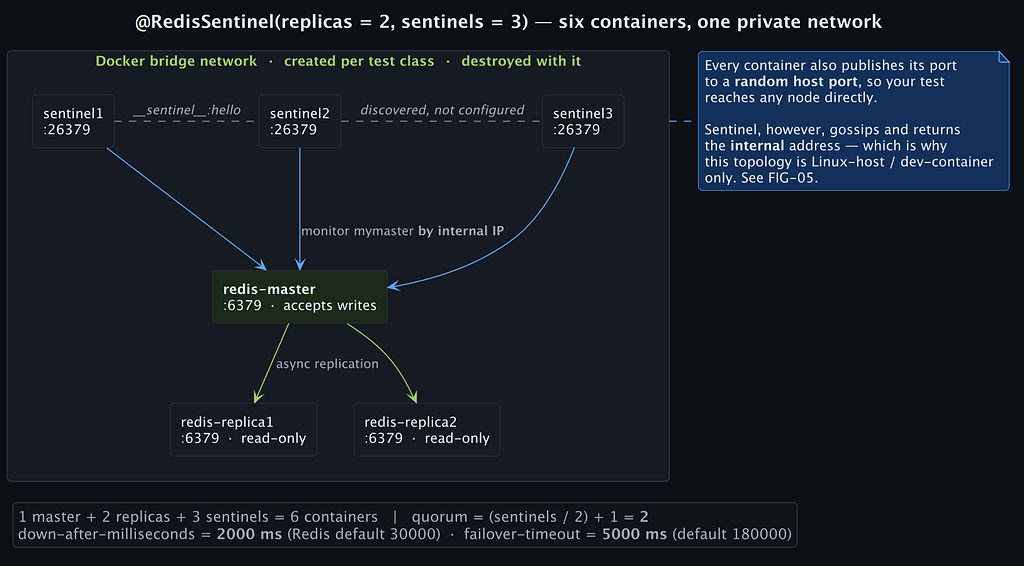
Zes containers, in de enige volgorde die werkt
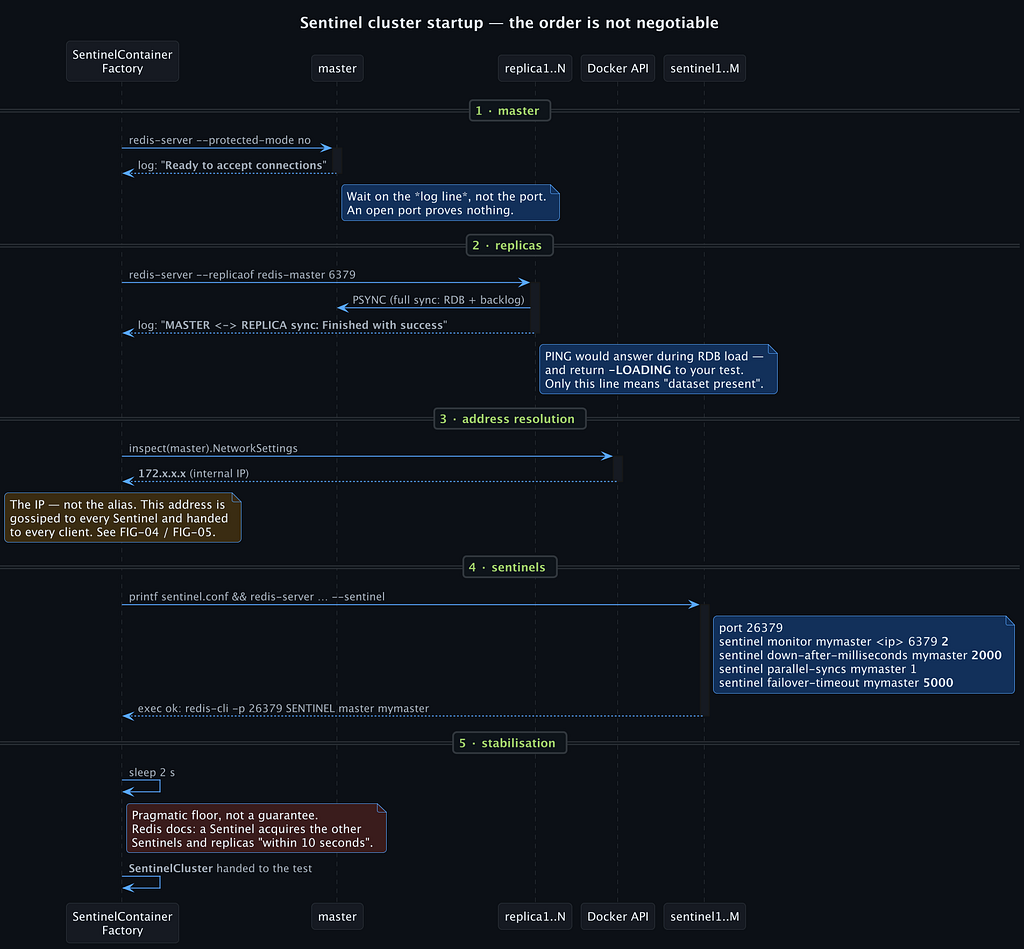
Sentinel volgt een master op adres, dus de opstartvolgorde ligt vast. Vier fasen lopen na elkaar, elk gekoppeld aan een semantisch signaal in plaats van een sleep: de master aan Ready to accept connections, de replica's aan MASTER <-> REPLICA sync: Finished with success, de Sentinels aan een geslaagde SENTINEL master mymaster, en daarna een vast stabilisatievenster van twee seconden. Het replicasignaal is het belangrijkste: een open poort of een PING slaagt terwijl een replica de RDB nog laadt, en uw eerste echte commando krijgt -LOADING.
Elke Sentinel kent alleen het interne Docker-IP van de master en ontdekt peers en replica's via __sentinel__:hello. Redis documenteert volledige ontdekking binnen 10 seconden, dus de wachttijd van twee seconden is een pragmatische ondergrens, geen bewijs dat de gossip tot rust is gekomen: controleer dat een failover voltooid wordt, niet num-other-sentinels op t=0.
down-after-milliseconds gaat van de Redis-standaard 30 000 naar 2 000, en failover-timeout van 180 000 naar 5 000. De standaard is juist in productie, waar een GC-pauze geen failover mag veroorzaken, maar maakt de assertie onschrijfbaar binnen een CI-budget. De prijs is een krap venster: op een zwaar belaste runner kan een test die controleert dat er geen failover plaatsvond flaky worden; verruim het voor die klasse.
Quorum is niet de verkiezingsmeerderheid
Het quorum is het aantal Sentinels dat onafhankelijk SDOWN moet bereiken voordat het oordeel ODOWN wordt, en ODOWN geeft alleen toestemming voor een failoverpoging. Uitvoeren vraagt een leider die door een meerderheid van alle Sentinels wordt gekozen en met een unieke configuration epoch wordt geversioneerd. Quorum = 1 bij vijf Sentinels levert dus snel ODOWN op en verder niets als maar twee van hen elkaar zien. De meerderheidsregel voorkomt ook dat een afgesneden minderheid een tweede master promoveert. De module leidt quorum = (sentinels / 2) + 1 af, zodat ODOWN samenvalt met de verkiezingsmeerderheid.
Eén scherpe rand, benoemd voordat u erop stuit: op dit moment bereiken quorum(), version() en masterName() op @RedisSentinel de containerconfiguratie niet. De standaardwaarden werken correct, maar de configuratie bewaakt altijd mymaster en de nodes draaien op redis:7-alpine. Totdat dat is doorgekoppeld, geeft u mymaster door aan uw client.
Alleen Linux, en daar eerlijk over
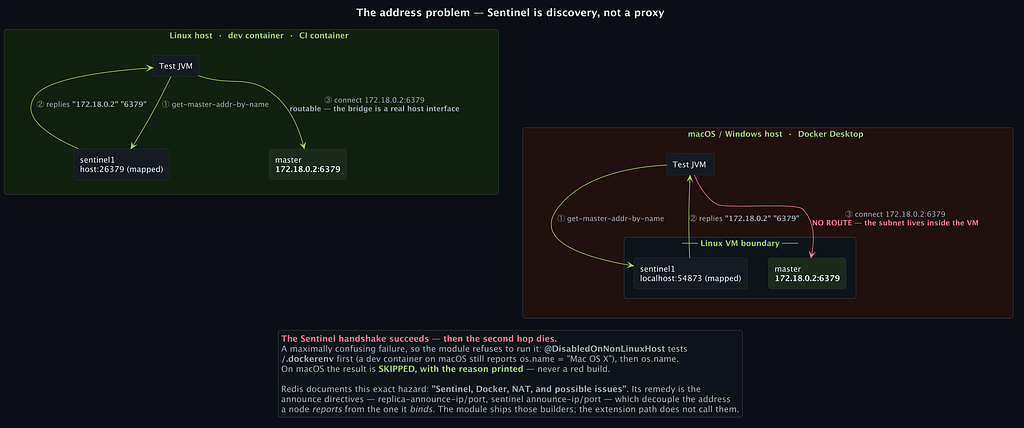
Sentinel is een discoveryprotocol, geen proxy. Een Sentinel-bewuste client vraagt naar de master, krijgt het interne adres terug, bijvoorbeeld 172.18.0.2:6379, en maakt daar direct verbinding mee. Op een Linux-host, of in een container die het netwerk van de daemon deelt, is dat adres routeerbaar. Op macOS of Windows houdt Docker Desktop de bridge in een VM, en elke Sentinel-bewuste client sneuvelt op die tweede hop — vlak nadat de handshake al geslaagd is.
De module bevat builders voor de announce-directives die dit zouden oplossen, maar het huidige extensiepad roept ze niet aan. Daarom draagt @RedisSentinel @DisabledOnNonLinuxHost, dat eerst op /.dockerenv controleert en pas daarna op os.name, zodat een dev container op een Mac gewoon draait. Op een macOS-laptop eindigt de Sentinel-suite na twee seconden met vier SKIPPED-tests en de reden erbij. Een rode build die niemand lokaal kan oplossen leert een team rode builds te negeren; een skip met reden houdt de suite betrouwbaar.
Failover als assertie
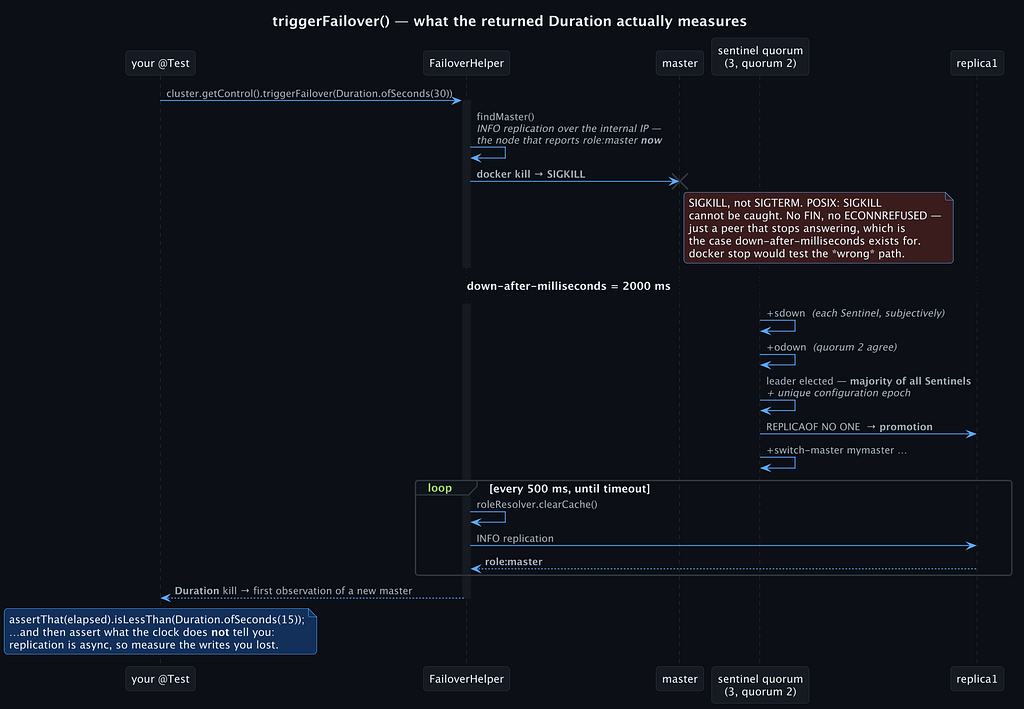
triggerFailover() vindt de container die op dit moment role:master meldt — door Redis via INFO replication te bevragen, niet Docker — en beëindigt die met SIGKILL. SIGTERM zou Redis zijn sockets netjes laten sluiten en de Sentinels via een ander, meestal sneller detectiepad sturen dan bij een echte node-uitval. Daarna wordt elke 500 ms gepolld, waarbij de rolcache bij elke ronde wordt geleegd, en komt de Duration terug van de kill tot de eerste waarneming van een nieuwe master, of wordt een FailoverException gegooid met de timeout, de verstreken tijd en het aantal pogingen.
De klok is maar de helft van het verhaal. Redis repliceert asynchroon, dus een promotie kan het staartje van de schrijfstroom weggooien. Schrijf een monotone reeks, start de failover, lees de reeks terug van de nieuwe master en controleer het verlies dat u kunt tolereren. Is het antwoord geen, dan zijn WAIT, min-replicas-to-write en min-replicas-max-lag op precies dezelfde manier te testen.
@RedisSentinel(replicas = 2, sentinels = 3)
class FailoverTest {

  @Test
  void promotesWithinSlo(SentinelCluster cluster) {
    Duration elapsed = cluster.getControl().triggerFailover(Duration.ofSeconds(30));

    assertThat(elapsed).isLessThan(Duration.ofSeconds(15));
    assertThat(cluster.getControl().getMaster().isRunning()).isTrue();
  }
}
Echte fouten op een echte topologie
Met een echte topologie eronder worden de onderliggende lagen instrumenten. enableNetworkChaos = true kent NET_ADMIN toe, nooit --privileged, voor latency, jitter en pakketverlies via tc/netem en partities via iptables. enableConnectionChaos = true laadt libchaos-net voordat de container start, voor errno-injectie op connect, send, recv en andere socketaanroepen. De twee zijn combineerbaar: een retry-lus verdraagt 5 % pakketverlies moeiteloos en valt toch om bij één ECONNRESET uit send().
Een klokafwijking van twee seconden of meer brengt een Sentinel in TILT-modus, waarin hij blijft bewaken maar niet meer handelt, zichtbaar als sentinel_tilt in INFO. En de storing van het begin wordt reproduceerbaar: één libchaos-io-regel die EIO teruggeeft bij schrijven laat de snapshot mislukken, en de assertie is één regel — uw schrijfpad moet een concrete, bruikbare fout opleveren in plaats van schrijfacties kwijt te raken. Daarboven bundelt macstab-chaos-testpacks-l3-redis samengestelde fouten tot benoemde incidenten op methodeniveau:
- @IncidentChaosRedisNetworkFlap: ECONNRESET op connect en recv, wat een verkiezingsstorm veroorzaakt in plaats van een nette failover
- @IncidentChaosRedisFailoverStorm: ECONNREFUSED op connect, EAI_AGAIN bij DNS-lookups en een CLOCK_REALTIME-offset
- @IncidentChaosRedisClockDrift: klokafwijking tussen nodes, races bij het verlopen van TTL's en een Sentinel die zijn eigen timeouts verkeerd berekent
- @IncidentChaosRedisOomEviction, @IncidentChaosRedisCacheAvalanche en @IncidentChaosRedisSlowlog: eviction onder geheugendruk, gesynchroniseerde verloopstormen en latency op SLOWLOG-niveau
Key Takeaways
Een pod killen beantwoordt precies één vraag: gaat het systeem dood? Een echt Sentinel-cluster in een JUnit-test beantwoordt de vraag die uw code werkelijk verandert: wat uw clientbibliotheek doet tijdens een promotie, welke verbinding ze nog vasthoudt, van welke node ze leest, hoeveel schrijfacties verloren gingen en hoe lang het duurde voordat iemand het merkte.
De grenzen staan vooraf vast: de Redis Cluster-modus wordt niet gedekt, Sentinel draait alleen op een Linux-host of in een container, drie attributen van @RedisSentinel zijn nog niet doorgekoppeld en het geheugenbudget is een nominale vangrail, geen meting. Binnen die grenzen wordt een failover iets waarop een pull request rood kan gaan. De module heet macstab-chaos-redis, Apache 2.0, op github.com/macstab/chaos-testing.
Christian Schnapka
Macstab Engineering
Christian Schnapka bouwt de open engineeringtools achter Macstab. De uitgebreide versies van deze onderzoeken publiceert hij op Medium — inclusief elke meting, elk voorbehoud en elk verlies.