Código-fonte no GitHub
Verde em todos os dashboards, cada escrita recusada
O seu Redis está ativo. Responde a PING. As réplicas estão sincronizadas, todos os dashboards estão verdes — e há quarenta minutos que recusa cada escrita.
Falhou um único snapshot em segundo plano, e isso bastou. stop-writes-on-bgsave-error vem definido como yes, por isso a partir desse momento o Redis rejeita tudo o que altere o conjunto de dados. As leituras continuam perfeitas. O master responde a PING, a única coisa que o health check do Sentinel consulta, por isso nada escala para ODOWN e nenhum failover é alguma vez iniciado.
E o código que escreveu para a outra falha, aquela em que um nó morre de verdade, nunca foi executado. Ensaiá-la com honestidade exige um master, duas réplicas, três Sentinels, um quórum correto, replicação convergida e um kill no instante exato. Por isso a cache é simulada com mocks, e a primeira vez que a sua biblioteca cliente vê um +switch-master é às 03:14 em produção.
macstab-chaos-redis, a terceira camada do Macstab Chaos Stack, elimina essa desculpa. Por baixo estão seis bibliotecas C99 LD_PRELOAD e um agente de bytecode para a JVM. Esta camada fornece o que nenhuma delas consegue: uma topologia com forma de produção onde injetar falhas.
Uma anotação em vez de noventa linhas
Depois da dependência, uma única anotação ao nível da classe é toda a configuração. @RedisStandalone dá-lhe um Redis 7.4 real numa porta aleatória. @RedisSentinel dá-lhe um master, duas réplicas e três Sentinels com quórum 2, na sua própria rede Docker privada. Sem @Testcontainers, sem campo de contentor estático, sem @DynamicPropertySource, sem o @AfterAll que pretendia escrever e nunca escreveu. Handles como SentinelCluster chegam como parâmetros do método de teste.
O equivalente Sentinel escrito à mão tem cerca de noventa linhas e carrega conhecimento que o código nunca explicita: uma linha de log específica é a única prova de que uma réplica terminou a sincronização, o Sentinel tem de receber um IP e não um alias, e 2 000 tem de substituir o valor por omissão de 30 000, ou nenhuma asserção conseguirá terminar. Apague qualquer um deles e os testes continuam a compilar. Simplesmente começam a mentir. Com a anotação, esse conhecimento vive na framework, escrito uma vez e coberto por testes. A limpeza passa pelo store CloseableResource do JUnit, com o reaper Ryuk do Testcontainers como segundo caminho independente.
// Gradle
testImplementation 'com.macstab.chaos:macstab-chaos-redis:1.0.0'

@RedisSentinel                       // 1 master + 2 replicas + 3 sentinels, quorum 2
class FailoverTest { }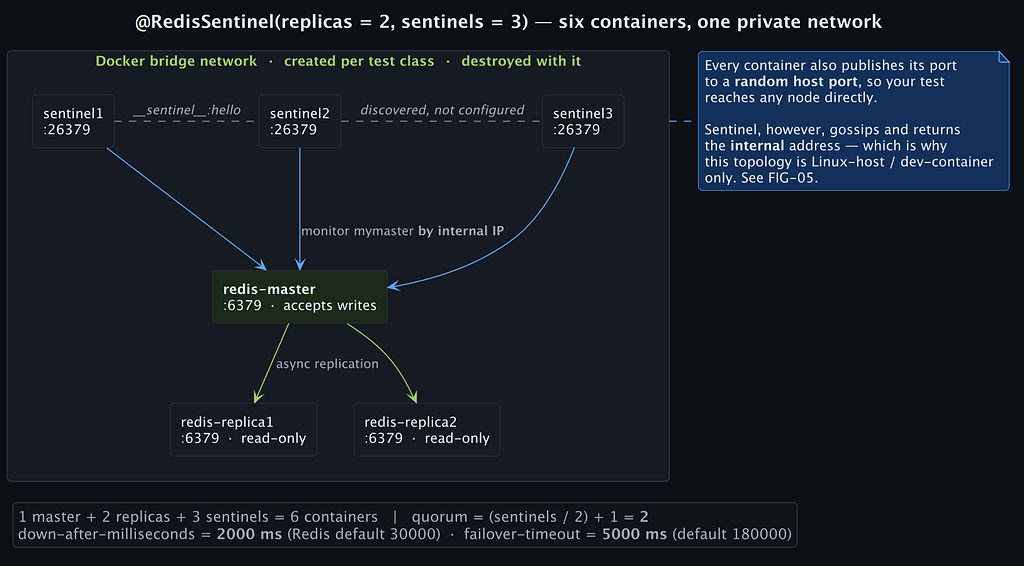
Seis contentores, na única ordem que funciona
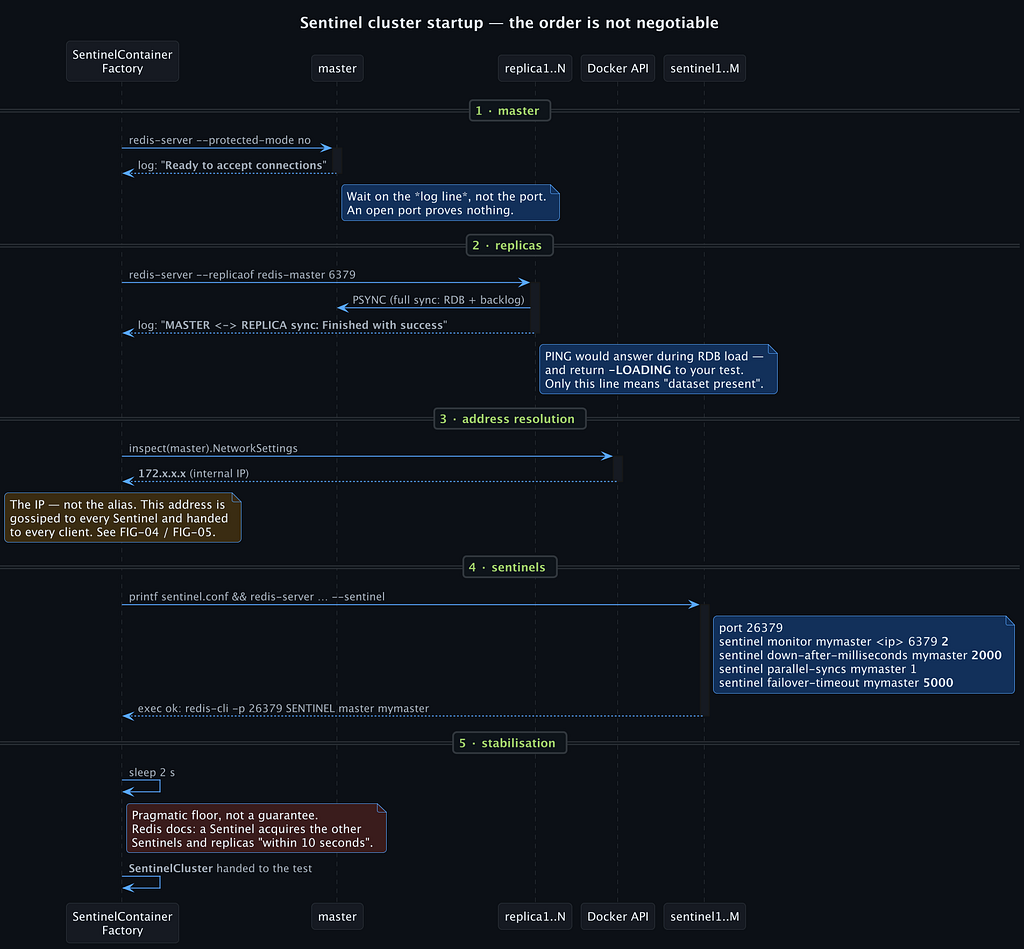
O Sentinel acompanha um master pelo endereço, por isso a ordem de arranque não é negociável. Quatro fases correm em sequência, cada uma dependente de um sinal semântico em vez de um sleep: o master de Ready to accept connections, as réplicas de MASTER <-> REPLICA sync: Finished with success, os Sentinels de um SENTINEL master mymaster bem-sucedido e, por fim, uma janela fixa de estabilização de dois segundos. O sinal das réplicas é o mais importante: uma porta aberta ou um PING têm sucesso enquanto a réplica ainda carrega o RDB, e o seu primeiro comando real recebe -LOADING.
Cada Sentinel conhece apenas o IP Docker interno do master e descobre os pares e as réplicas através de __sentinel__:hello. O Redis documenta a descoberta completa em até 10 segundos, por isso a espera de dois segundos é um mínimo pragmático, não uma prova de que o gossip estabilizou: verifique que um failover se conclui, não num-other-sentinels em t=0.
down-after-milliseconds desce do valor por omissão do Redis, 30 000, para 2 000, e failover-timeout de 180 000 para 5 000. O valor por omissão está certo em produção, onde uma pausa de GC não deve desencadear um failover, mas torna a asserção impossível de escrever dentro de um orçamento de CI. O preço é uma janela apertada: num runner sobrecarregado, um teste que verifica que não houve failover pode tornar-se instável; alargue-a para essa classe.
O quórum não é a maioria eleitoral
O quórum é o número de Sentinels que têm de atingir SDOWN de forma independente antes de o veredicto passar a ODOWN, e ODOWN apenas autoriza uma tentativa de failover. Executá-la exige um líder eleito pela maioria de todos os Sentinels, versionado por uma configuration epoch única. Assim, quorum = 1 em cinco Sentinels produz um ODOWN rápido e mais nada se apenas dois deles se virem. A regra da maioria também impede que uma minoria isolada promova um segundo master. O módulo calcula quorum = (sentinels / 2) + 1, alinhando o ODOWN com a maioria eleitoral.
Uma aresta afiada, indicada antes que tropece nela: atualmente, quorum(), version() e masterName() em @RedisSentinel não chegam à configuração dos contentores. Os valores por omissão funcionam corretamente, mas a configuração monitoriza sempre mymaster e os nós correm redis:7-alpine. Até isso estar ligado, passe mymaster ao seu cliente.
Apenas Linux, e com honestidade
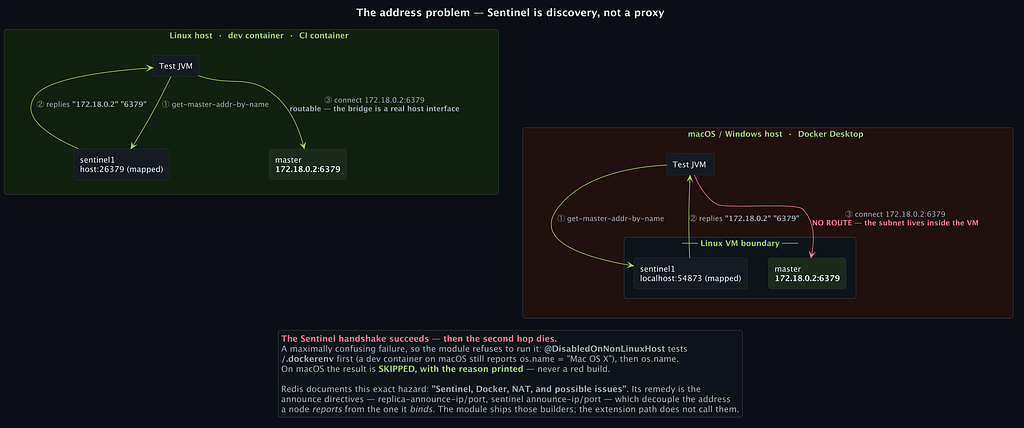
O Sentinel é um protocolo de descoberta, não um proxy. Um cliente compatível com Sentinel pergunta pelo master, recebe o endereço interno, por exemplo 172.18.0.2:6379, e liga-se diretamente a ele. Num host Linux, ou dentro de um contentor que partilha a rede do daemon, esse endereço é encaminhável. Em macOS ou Windows, o Docker Desktop mantém a bridge dentro de uma VM, e todos os clientes compatíveis com Sentinel falham nesse segundo salto — logo depois de o handshake ter sido bem-sucedido.
O módulo contém builders para as diretivas announce que resolveriam isto, mas o caminho atual da extensão não os invoca. Por isso, @RedisSentinel traz @DisabledOnNonLinuxHost, que verifica /.dockerenv antes de os.name, para que um dev container num Mac continue a correr. Num portátil macOS, a suite Sentinel termina em dois segundos com quatro testes SKIPPED e o motivo impresso. Um build vermelho que ninguém consegue corrigir localmente ensina uma equipa a ignorar builds vermelhos; um skip com motivo mantém a suite fiável.
O failover como asserção
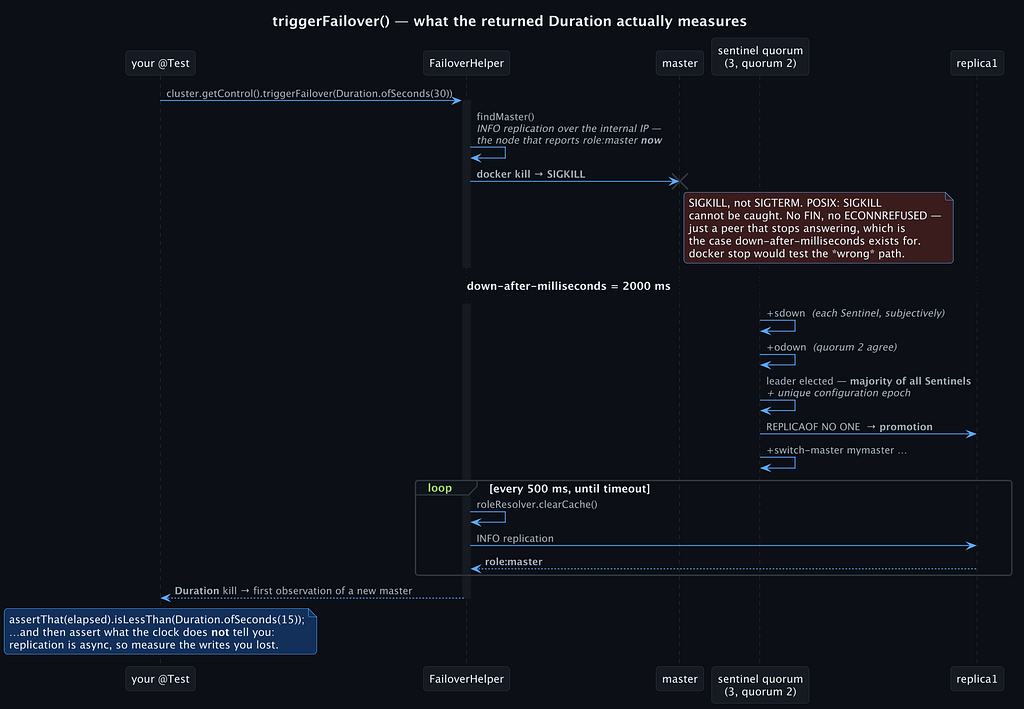
triggerFailover() encontra o contentor que reporta role:master neste exato momento — perguntando ao Redis via INFO replication, não ao Docker — e termina-o com SIGKILL. SIGTERM deixaria o Redis fechar os seus sockets de forma ordenada e levaria os Sentinels por um caminho de deteção diferente, normalmente mais rápido, do que a morte real de um nó. Depois faz polling a cada 500 ms, limpando a cache de papéis em cada passagem, e devolve a Duration desde o kill até à primeira observação de um novo master, ou lança uma FailoverException com o timeout, o tempo decorrido e o número de tentativas.
O relógio é só metade da história. O Redis replica de forma assíncrona, por isso uma promoção pode descartar o final do fluxo de escritas. Escreva uma sequência monótona, desencadeie o failover, leia-a de volta a partir do novo master e verifique a perda que consegue tolerar. Se a resposta for nenhuma, WAIT, min-replicas-to-write e min-replicas-max-lag testam-se exatamente da mesma forma.
@RedisSentinel(replicas = 2, sentinels = 3)
class FailoverTest {

  @Test
  void promotesWithinSlo(SentinelCluster cluster) {
    Duration elapsed = cluster.getControl().triggerFailover(Duration.ofSeconds(30));

    assertThat(elapsed).isLessThan(Duration.ofSeconds(15));
    assertThat(cluster.getControl().getMaster().isRunning()).isTrue();
  }
}
Falhas reais numa topologia real
Com uma topologia real por baixo, as camadas inferiores tornam-se instrumentos. enableNetworkChaos = true concede NET_ADMIN, nunca --privileged, para latência, jitter e perda de pacotes com tc/netem e partições com iptables. enableConnectionChaos = true carrega a libchaos-net antes de o contentor arrancar, para injeção de errno em connect, send, recv e outras chamadas de socket. As duas combinam-se: um ciclo de retry aguenta 5 % de perda de pacotes e mesmo assim cai perante um único ECONNRESET devolvido por send().
Um desvio de relógio de dois segundos ou mais coloca um Sentinel em modo TILT, no qual continua a monitorizar mas deixa de agir, visível como sentinel_tilt no INFO. E a falha do início torna-se reproduzível: uma regra da libchaos-io que devolve EIO na escrita faz falhar o snapshot, e a asserção ocupa uma linha — o seu caminho de escrita tem de lançar um erro específico e acionável em vez de perder escritas. Por cima, macstab-chaos-testpacks-l3-redis agrupa falhas compostas em incidentes com nome, ao nível do método:
- @IncidentChaosRedisNetworkFlap: ECONNRESET em connect e recv, provocando uma tempestade de eleições em vez de um failover limpo
- @IncidentChaosRedisFailoverStorm: ECONNREFUSED em connect, EAI_AGAIN nas consultas DNS e um desvio de CLOCK_REALTIME
- @IncidentChaosRedisClockDrift: desvio de relógio entre nós, corridas na expiração de TTL e o Sentinel a calcular mal os seus próprios timeouts
- @IncidentChaosRedisOomEviction, @IncidentChaosRedisCacheAvalanche e @IncidentChaosRedisSlowlog: eviction sob pressão de memória, tempestades de expiração sincronizadas e latência ao nível do SLOWLOG
Key Takeaways
Matar um pod responde exatamente a uma pergunta: o sistema morre? Um cluster Sentinel real dentro de um teste JUnit responde àquela que realmente muda o seu código: o que a sua biblioteca cliente faz durante uma promoção, que ligação ainda mantém, de que nó lê, quantas escritas se perderam e quanto tempo demorou a notar.
Os limites ficam declarados à partida: o modo Redis Cluster não está coberto, o Sentinel só corre num host Linux ou dentro de um contentor, três atributos de @RedisSentinel ainda não estão ligados e o orçamento de memória é uma salvaguarda nominal, não uma medição. Dentro desses limites, um failover torna-se algo que pode pôr uma pull request a vermelho. O módulo é o macstab-chaos-redis, Apache 2.0, em github.com/macstab/chaos-testing.
Christian Schnapka
Macstab Engineering
Christian Schnapka desenvolve as ferramentas de engenharia abertas por trás da Macstab. Publica as versões longas destas investigações no Medium — com cada medição, cada ressalva e cada perda incluídas.