Codice sorgente su GitHub
Verde su ogni dashboard, ogni scrittura rifiutata
Il vostro Redis è attivo. Risponde a PING. Le repliche sono sincronizzate, ogni dashboard è verde — e da quaranta minuti rifiuta ogni singola scrittura.
È fallito un solo snapshot in background, ed è bastato. stop-writes-on-bgsave-error è impostato di default su yes, quindi da quel momento Redis rifiuta tutto ciò che modifica il dataset. Le letture continuano a sembrare perfette. Il master risponde a PING, l'unica cosa che l'health check di Sentinel consulta, quindi nulla passa a ODOWN e nessun failover viene mai avviato.
E il codice che avete scritto per l'altro guasto, quello in cui un nodo muore davvero, non è mai stato eseguito. Provarlo onestamente significa un master, due repliche, tre Sentinel, un quorum corretto, una replica convergente e un kill nell'istante esatto. Così la cache viene mockata, e la prima volta che la vostra libreria client vede un +switch-master è alle 03:14 in produzione.
macstab-chaos-redis, il terzo livello del Macstab Chaos Stack, toglie questa scusa. Sotto ci sono sei librerie C99 LD_PRELOAD e un agente bytecode per la JVM. Questo livello fornisce ciò che nessuno dei due può offrire: una topologia simile alla produzione in cui iniettare guasti.
Un'annotazione invece di novanta righe
Dopo la dipendenza, una sola annotazione a livello di classe è l'intero setup. @RedisStandalone vi dà un vero Redis 7.4 su una porta casuale. @RedisSentinel vi dà un master, due repliche e tre Sentinel con quorum 2, sulla loro rete Docker privata. Niente @Testcontainers, niente campo container statico, niente @DynamicPropertySource, niente @AfterAll che volevate scrivere e non avete mai scritto. Handle come SentinelCluster arrivano come parametri del metodo di test.
L'equivalente Sentinel scritto a mano è di circa novanta righe e porta un carico che il codice non dichiara mai: una specifica riga di log è l'unica prova che una replica ha finito la sincronizzazione, Sentinel deve ricevere un IP e non un alias, e 2 000 deve sostituire il default di 30 000, altrimenti nessuna asserzione potrà mai concludersi. Eliminatene uno e i test compilano ancora. Semplicemente iniziano a mentire. Con l'annotazione, questa conoscenza vive nel framework, scritta una volta e coperta da test. Il teardown passa dallo store CloseableResource di JUnit, con il reaper Ryuk di Testcontainers come secondo percorso indipendente.
// Gradle
testImplementation 'com.macstab.chaos:macstab-chaos-redis:1.0.0'

@RedisSentinel                       // 1 master + 2 replicas + 3 sentinels, quorum 2
class FailoverTest { }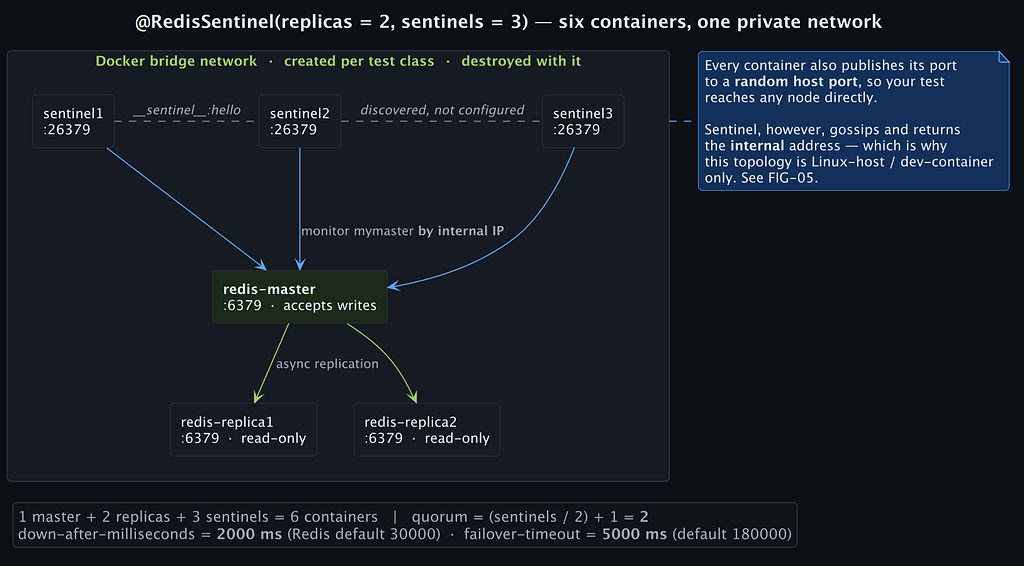
Sei container, nell'unico ordine che funziona
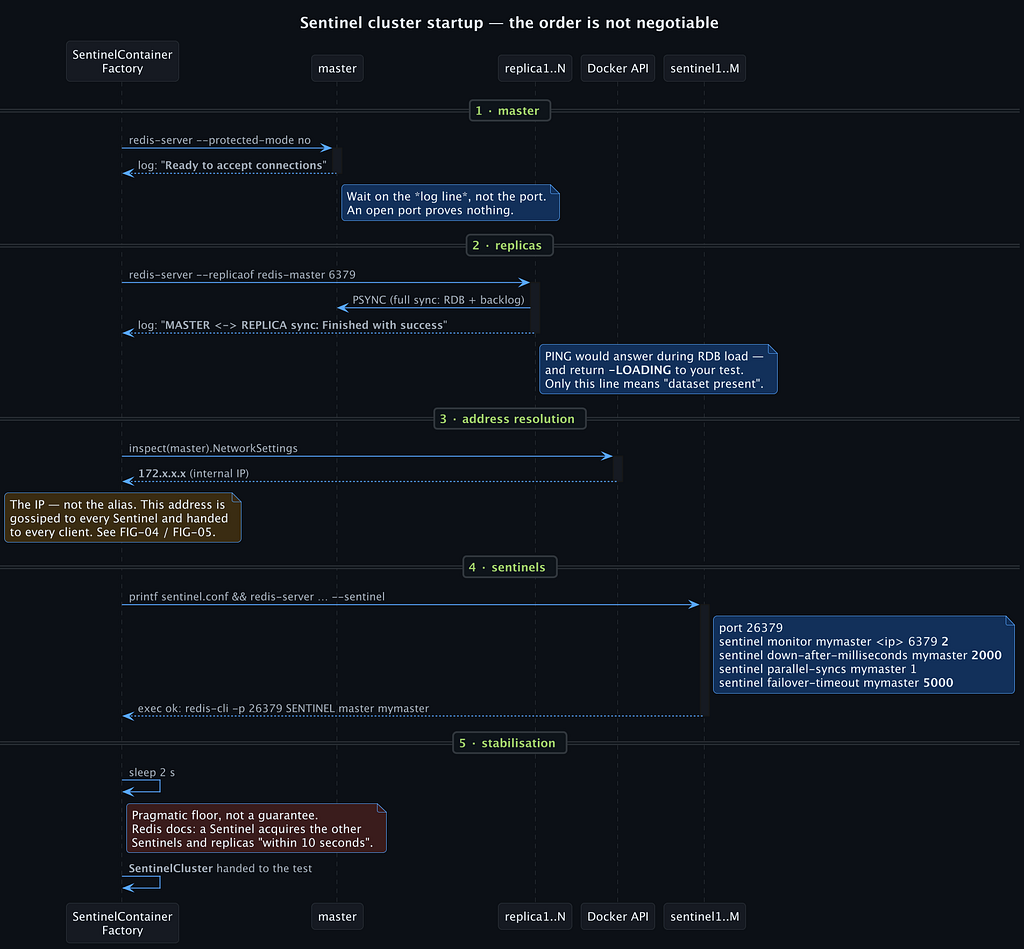
Sentinel segue un master tramite il suo indirizzo, quindi l'ordine di avvio non è negoziabile. Quattro fasi si susseguono, ciascuna vincolata a un segnale semantico anziché a uno sleep: il master a Ready to accept connections, le repliche a MASTER <-> REPLICA sync: Finished with success, i Sentinel a un SENTINEL master mymaster riuscito, poi una finestra di stabilizzazione fissa di due secondi. Il segnale delle repliche è il più importante: una porta aperta o un PING riescono mentre una replica sta ancora caricando l'RDB, e il vostro primo comando reale riceve -LOADING.
Ogni Sentinel conosce solo l'IP Docker interno del master e scopre peer e repliche tramite __sentinel__:hello. Redis documenta la scoperta completa entro 10 secondi, quindi l'attesa di due secondi è una soglia pragmatica, non la prova che il gossip si sia assestato: verificate che un failover si completi, non num-other-sentinels a t=0.
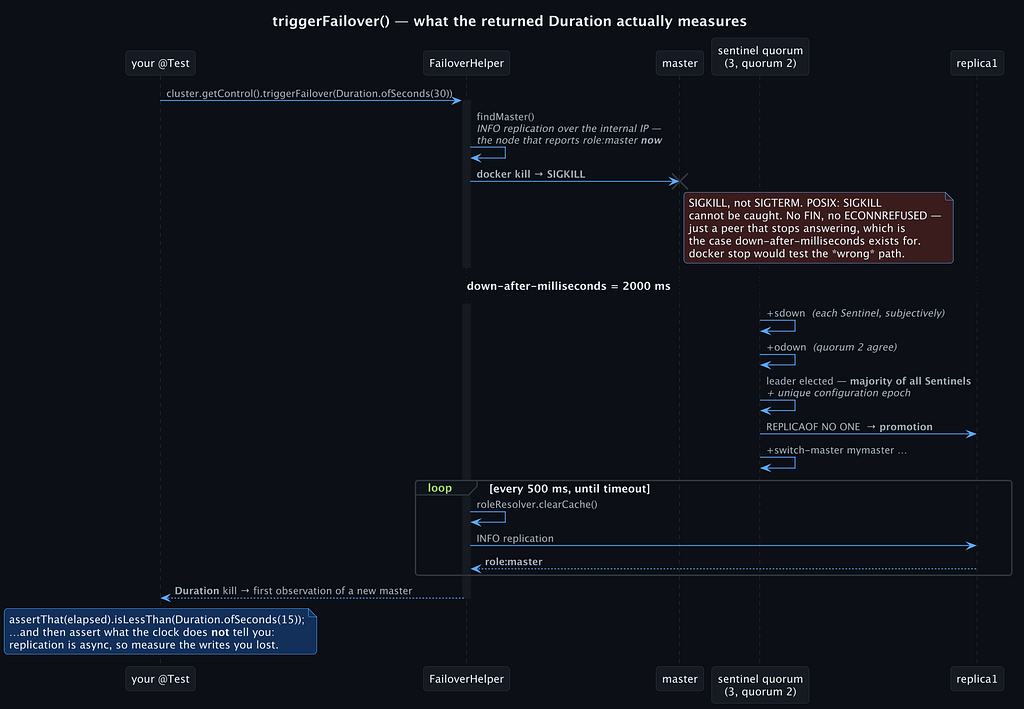
down-after-milliseconds scende dal default di Redis di 30 000 a 2 000, e failover-timeout da 180 000 a 5 000. Il default è corretto in produzione, dove una pausa del GC non deve innescare un failover, ma rende l'asserzione impossibile da scrivere entro un budget di CI. Il prezzo è una finestra stretta: su un runner carico, un test che verifica che nessun failover sia avvenuto può diventare instabile; allargatela per quella classe.
Il quorum non è la maggioranza elettorale
Il quorum è il numero di Sentinel che devono raggiungere SDOWN in modo indipendente prima che il verdetto diventi ODOWN, e ODOWN autorizza soltanto un tentativo di failover. Eseguirlo richiede un leader eletto dalla maggioranza di tutti i Sentinel, versionato da una configuration epoch univoca. Quindi quorum = 1 su cinque Sentinel produce un ODOWN rapido e nient'altro, se solo due di loro si vedono. La regola di maggioranza impedisce anche a una minoranza isolata di promuovere un secondo master. Il modulo calcola quorum = (sentinels / 2) + 1, allineando ODOWN alla maggioranza elettorale.
Un punto critico, segnalato prima che ci inciampiate: oggi quorum(), version() e masterName() su @RedisSentinel non arrivano alla configurazione dei container. I default funzionano correttamente, ma la configurazione monitora sempre mymaster e i nodi girano su redis:7-alpine. Finché non viene collegato, passate mymaster al vostro client.
Solo Linux, e senza nasconderlo
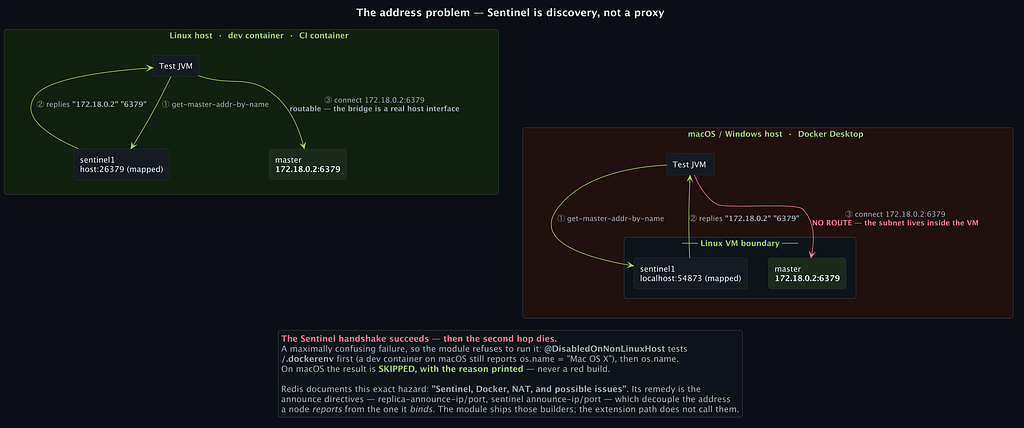
Sentinel è un protocollo di discovery, non un proxy. Un client compatibile con Sentinel chiede il master, riceve l'indirizzo interno, ad esempio 172.18.0.2:6379, e vi si connette direttamente. Su un host Linux, o dentro un container che condivide la rete del daemon, quell'indirizzo è instradabile. Su macOS o Windows, Docker Desktop tiene il bridge dentro una VM, e ogni client compatibile con Sentinel fallisce su quel secondo salto, subito dopo che l'handshake è riuscito.
Il modulo contiene builder per le direttive announce che risolverebbero il problema, ma il percorso attuale dell'estensione non li invoca. Per questo @RedisSentinel porta @DisabledOnNonLinuxHost, che controlla /.dockerenv prima di os.name, così un dev container su Mac continua a funzionare. Su un portatile macOS la suite Sentinel termina in due secondi con quattro test SKIPPED e il motivo stampato. Una build rossa che nessuno può correggere in locale insegna a un team a ignorare le build rosse; uno skip motivato mantiene la suite affidabile.
Il failover come asserzione
triggerFailover() individua il container che in questo preciso momento riporta role:master — interrogando Redis tramite INFO replication, non Docker — e lo termina con SIGKILL. SIGTERM lascerebbe Redis chiudere ordinatamente i socket e porterebbe i Sentinel su un percorso di rilevamento diverso, di solito più rapido, rispetto alla morte reale di un nodo. Poi esegue un polling ogni 500 ms, svuotando la cache dei ruoli a ogni passaggio, e restituisce la Duration dal kill al primo avvistamento di un nuovo master, oppure lancia una FailoverException con timeout, tempo trascorso e numero di tentativi.
Il cronometro è solo metà della storia. Redis replica in modo asincrono, quindi una promozione può scartare la coda del flusso di scritture. Scrivete una sequenza monotona, innescate il failover, rileggetela dal nuovo master e verificate la perdita che potete tollerare. Se la risposta è nessuna, WAIT, min-replicas-to-write e min-replicas-max-lag si testano esattamente allo stesso modo.
@RedisSentinel(replicas = 2, sentinels = 3)
class FailoverTest {

  @Test
  void promotesWithinSlo(SentinelCluster cluster) {
    Duration elapsed = cluster.getControl().triggerFailover(Duration.ofSeconds(30));

    assertThat(elapsed).isLessThan(Duration.ofSeconds(15));
    assertThat(cluster.getControl().getMaster().isRunning()).isTrue();
  }
}
Guasti reali su una topologia reale
Con una topologia reale sotto, i livelli inferiori diventano strumenti. enableNetworkChaos = true concede NET_ADMIN, mai --privileged, per latenza, jitter e perdita di pacchetti con tc/netem e partizioni con iptables. enableConnectionChaos = true carica libchaos-net prima dell'avvio del container, per l'iniezione di errno su connect, send, recv e altre chiamate socket. I due si combinano: un ciclo di retry sopporta il 5 % di perdita di pacchetti e cade comunque su un singolo ECONNRESET restituito da send().
Uno sfasamento dell'orologio di due secondi o più porta un Sentinel in modalità TILT, in cui continua a monitorare ma smette di agire, visibile come sentinel_tilt in INFO. E il guasto dell'inizio diventa riproducibile: una regola libchaos-io che restituisce EIO in scrittura fa fallire lo snapshot, e l'asserzione è una riga — il vostro percorso di scrittura deve sollevare un errore specifico e gestibile invece di perdere scritture. Più in alto, macstab-chaos-testpacks-l3-redis raggruppa guasti composti in incidenti con nome, a livello di metodo:
- @IncidentChaosRedisNetworkFlap: ECONNRESET su connect e recv, che produce una tempesta di elezioni invece di un failover pulito
- @IncidentChaosRedisFailoverStorm: ECONNREFUSED su connect, EAI_AGAIN sulle risoluzioni DNS e uno sfasamento di CLOCK_REALTIME
- @IncidentChaosRedisClockDrift: sfasamento degli orologi tra nodi, race sulla scadenza dei TTL e Sentinel che calcola male i propri timeout
- @IncidentChaosRedisOomEviction, @IncidentChaosRedisCacheAvalanche e @IncidentChaosRedisSlowlog: eviction sotto pressione di memoria, tempeste di scadenze sincronizzate e latenza a livello SLOWLOG
Key Takeaways
Uccidere un pod risponde esattamente a una domanda: il sistema muore? Un vero cluster Sentinel dentro un test JUnit risponde a quella che cambia davvero il vostro codice: cosa fa la vostra libreria client durante una promozione, quale connessione tiene ancora, da quale nodo legge, quante scritture sono andate perse e quanto tempo è servito per accorgersene.
I limiti sono dichiarati in anticipo: la modalità Redis Cluster non è coperta, Sentinel funziona solo su un host Linux o dentro un container, tre attributi di @RedisSentinel non sono ancora collegati e il budget di memoria è un parapetto nominale, non una misurazione. Entro questi limiti, un failover diventa qualcosa che può far diventare rossa una pull request. Il modulo è macstab-chaos-redis, Apache 2.0, su github.com/macstab/chaos-testing.
Christian Schnapka
Macstab Engineering
Christian Schnapka sviluppa gli strumenti di ingegneria open dietro Macstab. Pubblica le versioni estese di queste indagini su Medium, con ogni misurazione, ogni avvertenza e ogni perdita incluse.