Código fuente en GitHub
En verde en todos los paneles, rechazando cada escritura
Su Redis está activo. Responde a PING. Sus réplicas están sincronizadas, todos los paneles están en verde — y lleva cuarenta minutos rechazando cada escritura.
Falló un único snapshot en segundo plano, y bastó. stop-writes-on-bgsave-error viene configurado en yes, así que desde ese momento Redis rechaza todo lo que modifique el conjunto de datos. Las lecturas siguen pareciendo perfectas. El master responde a PING, lo único que consulta el health check de Sentinel, así que nada escala a ODOWN y nunca se inicia un failover.
Y el código que escribió para el otro fallo, aquel en el que un nodo muere de verdad, nunca se ha ejecutado. Ensayarlo con honestidad requiere un master, dos réplicas, tres Sentinels, un quórum correcto, replicación convergida y un kill en el instante exacto. Así que el caché se simula con mocks, y la primera vez que su biblioteca cliente ve un +switch-master es a las 03:14 en producción.
macstab-chaos-redis, la tercera capa del Macstab Chaos Stack, elimina esa excusa. Debajo hay seis bibliotecas C99 LD_PRELOAD y un agente de bytecode para la JVM. Esta capa aporta lo que ninguna de las dos puede: una topología con forma de producción en la que inyectar fallos.
Una anotación en lugar de noventa líneas
Tras añadir la dependencia, una sola anotación a nivel de clase es toda la configuración. @RedisStandalone le da un Redis 7.4 real en un puerto aleatorio. @RedisSentinel le da un master, dos réplicas y tres Sentinels con quórum 2, en su propia red Docker privada. Sin @Testcontainers, sin campo de contenedor estático, sin @DynamicPropertySource, sin el @AfterAll que pensaba escribir y nunca escribió. Los handles como SentinelCluster llegan como parámetros del método de test.
El equivalente Sentinel escrito a mano ocupa unas noventa líneas y sostiene conocimiento que el código nunca hace explícito: una línea de log concreta es la única prueba de que una réplica terminó de sincronizar, Sentinel necesita una IP y no un alias, y 2 000 debe sustituir al valor por defecto de 30 000 o ninguna aserción podrá terminar nunca. Borre cualquiera de ellos y los tests seguirán compilando. Simplemente empezarán a mentir. Con la anotación, ese conocimiento vive en el framework, escrito una vez y cubierto por tests. La limpieza pasa por el store CloseableResource de JUnit, con el reaper Ryuk de Testcontainers como segunda vía independiente.
// Gradle
testImplementation 'com.macstab.chaos:macstab-chaos-redis:1.0.0'

@RedisSentinel                       // 1 master + 2 replicas + 3 sentinels, quorum 2
class FailoverTest { }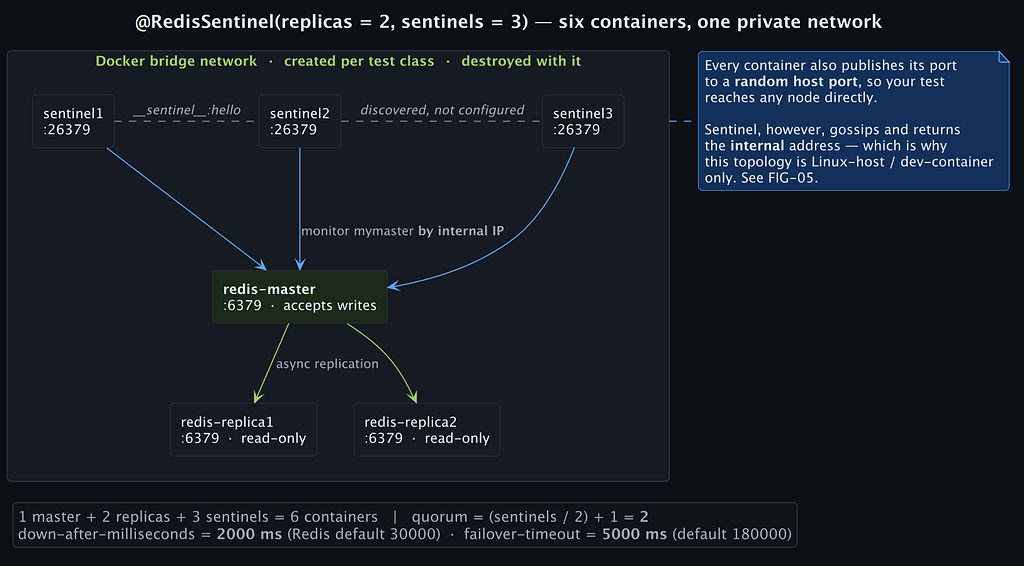
Seis contenedores, en el único orden que funciona
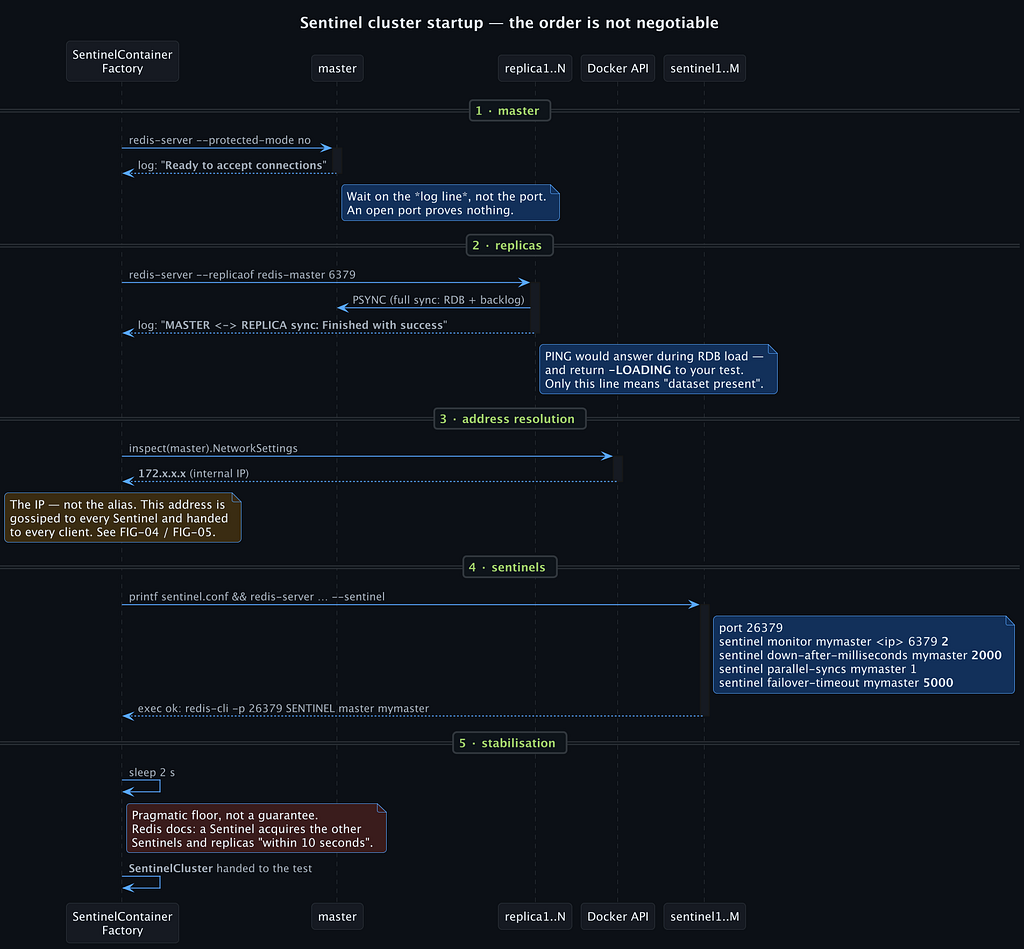
Sentinel sigue a un master por su dirección, así que el orden de arranque no es negociable. Cuatro fases se ejecutan en secuencia, cada una condicionada a una señal semántica en lugar de a un sleep: el master a Ready to accept connections, las réplicas a MASTER <-> REPLICA sync: Finished with success, los Sentinels a un SENTINEL master mymaster exitoso, y después una ventana de estabilización fija de dos segundos. La señal de las réplicas es la clave: un puerto abierto o un PING tienen éxito mientras la réplica aún carga el RDB, y su primer comando real recibe -LOADING.
Cada Sentinel solo conoce la IP interna de Docker del master y descubre a sus pares y a las réplicas mediante __sentinel__:hello. Redis documenta el descubrimiento completo en un plazo de 10 segundos, así que la espera de dos segundos es un mínimo pragmático, no una prueba de que el gossip se haya asentado: verifique que un failover se completa, no num-other-sentinels en t=0.
down-after-milliseconds baja del valor por defecto de Redis, 30 000, a 2 000, y failover-timeout de 180 000 a 5 000. El valor por defecto es correcto en producción, donde una pausa de GC no debe provocar un failover, pero hace imposible escribir la aserción dentro de un presupuesto de CI. El precio es una ventana estrecha: en un runner cargado, un test que verifica que no hubo failover puede volverse inestable; amplíela para esa clase.
El quórum no es la mayoría de elección
El quórum es el número de Sentinels que deben alcanzar SDOWN de forma independiente antes de que el veredicto pase a ODOWN, y ODOWN solo autoriza un intento de failover. Ejecutarlo requiere un líder elegido por la mayoría de todos los Sentinels, versionado mediante una configuration epoch única. Así, quorum = 1 con cinco Sentinels produce un ODOWN rápido y nada más si solo dos de ellos se ven entre sí. La regla de mayoría también impide que una minoría aislada promueva un segundo master. El módulo deriva quorum = (sentinels / 2) + 1, alineando ODOWN con la mayoría de elección.
Un punto delicado, señalado antes de que tropiece con él: hoy, quorum(), version() y masterName() de @RedisSentinel no llegan a la configuración de los contenedores. Los valores por defecto funcionan correctamente, pero la configuración siempre supervisa mymaster y los nodos ejecutan redis:7-alpine. Hasta que esto se conecte, pase mymaster a su cliente.
Solo Linux, y con honestidad
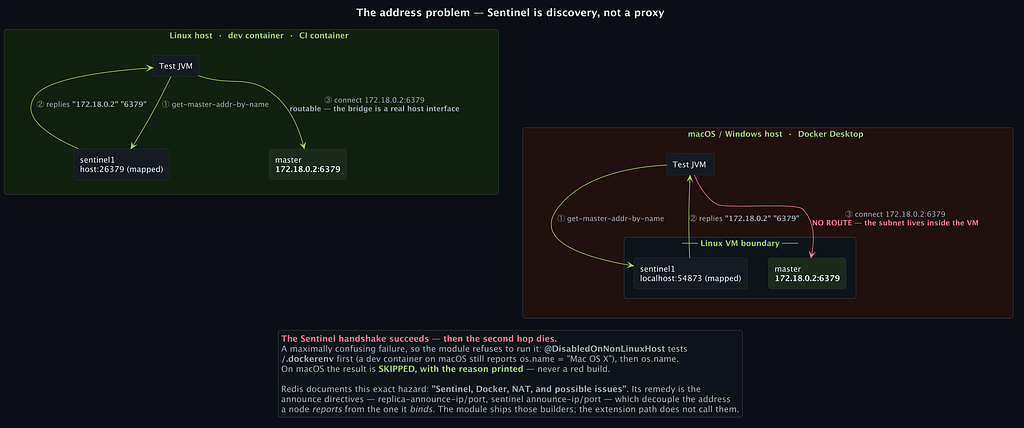
Sentinel es un protocolo de descubrimiento, no un proxy. Un cliente compatible con Sentinel pregunta por el master, recibe la dirección interna, por ejemplo 172.18.0.2:6379, y se conecta directamente a ella. En un host Linux, o dentro de un contenedor que comparte la red del daemon, esa dirección es enrutable. En macOS o Windows, Docker Desktop mantiene el bridge dentro de una VM, y todo cliente compatible con Sentinel falla en ese segundo salto, justo después de que el handshake haya tenido éxito.
El módulo incluye builders para las directivas announce que resolverían esto, pero la ruta actual de la extensión no los invoca. Por eso @RedisSentinel lleva @DisabledOnNonLinuxHost, que comprueba /.dockerenv antes que os.name, de modo que un dev container en un Mac sigue ejecutándose. En un portátil macOS, la suite Sentinel termina en dos segundos con cuatro tests SKIPPED y el motivo impreso. Un build en rojo que nadie puede arreglar en local enseña a un equipo a ignorar los builds en rojo; un skip con motivo mantiene la suite fiable.
El failover como aserción
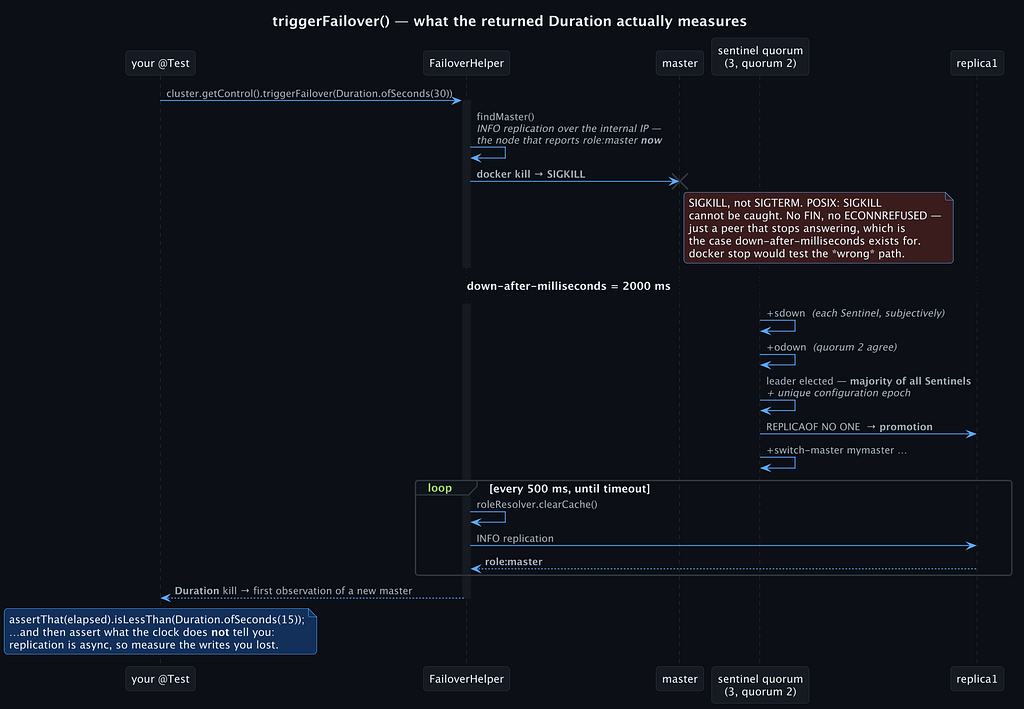
triggerFailover() localiza el contenedor que informa role:master en ese preciso momento — preguntando a Redis mediante INFO replication, no a Docker — y lo termina con SIGKILL. SIGTERM permitiría a Redis cerrar sus sockets limpiamente y llevaría a los Sentinels por una ruta de detección distinta, normalmente más rápida, que la muerte real de un nodo. Después sondea cada 500 ms, vaciando la caché de roles en cada pasada, y devuelve la Duration desde el kill hasta la primera observación de un nuevo master, o lanza una FailoverException con el timeout, el tiempo transcurrido y el número de reintentos.
El reloj es solo la mitad de la historia. Redis replica de forma asíncrona, así que una promoción puede descartar el final del flujo de escrituras. Escriba una secuencia monótona, provoque el failover, léala desde el nuevo master y verifique la pérdida que puede tolerar. Si la respuesta es ninguna, WAIT, min-replicas-to-write y min-replicas-max-lag se prueban exactamente igual.
@RedisSentinel(replicas = 2, sentinels = 3)
class FailoverTest {

  @Test
  void promotesWithinSlo(SentinelCluster cluster) {
    Duration elapsed = cluster.getControl().triggerFailover(Duration.ofSeconds(30));

    assertThat(elapsed).isLessThan(Duration.ofSeconds(15));
    assertThat(cluster.getControl().getMaster().isRunning()).isTrue();
  }
}
Fallos reales sobre una topología real
Con una topología real debajo, las capas inferiores se convierten en instrumentos. enableNetworkChaos = true concede NET_ADMIN, nunca --privileged, para latencia, jitter y pérdida de paquetes con tc/netem y particiones con iptables. enableConnectionChaos = true carga libchaos-net antes de que arranque el contenedor, para inyectar errno en connect, send, recv y otras llamadas de socket. Ambos se combinan: un bucle de reintentos tolera un 5 % de pérdida de paquetes y aun así cae ante un único ECONNRESET devuelto por send().
Un desfase de reloj de dos segundos o más lleva a un Sentinel al modo TILT, en el que sigue supervisando pero deja de actuar, visible como sentinel_tilt en INFO. Y el fallo del principio por fin es reproducible: una regla de libchaos-io que devuelve EIO al escribir hace fallar el snapshot, y la aserción ocupa una línea — su ruta de escritura debe lanzar un error concreto y accionable en lugar de perder escrituras. Por encima, macstab-chaos-testpacks-l3-redis agrupa fallos compuestos en incidentes con nombre a nivel de método:
- @IncidentChaosRedisNetworkFlap: ECONNRESET en connect y recv, que provoca una tormenta de elecciones en lugar de un failover limpio
- @IncidentChaosRedisFailoverStorm: ECONNREFUSED en connect, EAI_AGAIN en las consultas DNS y un desfase de CLOCK_REALTIME
- @IncidentChaosRedisClockDrift: desfase de reloj entre nodos, carreras en la expiración de TTL y Sentinel calculando mal sus propios timeouts
- @IncidentChaosRedisOomEviction, @IncidentChaosRedisCacheAvalanche y @IncidentChaosRedisSlowlog: evicción bajo presión de memoria, tormentas de expiración sincronizadas y latencia a nivel de SLOWLOG
Key Takeaways
Matar un pod responde exactamente a una pregunta: ¿muere el sistema? Un clúster Sentinel real dentro de un test JUnit responde a la que de verdad cambia su código: qué hace su biblioteca cliente durante una promoción, qué conexión sigue manteniendo, de qué nodo lee, cuántas escrituras se perdieron y cuánto tardó en darse cuenta.
Los límites se declaran de antemano: el modo Redis Cluster no está cubierto, Sentinel solo funciona en un host Linux o dentro de un contenedor, tres atributos de @RedisSentinel aún no están conectados y el presupuesto de memoria es una barrera nominal, no una medición. Dentro de esos límites, un failover se convierte en algo que puede poner en rojo una pull request. El módulo es macstab-chaos-redis, Apache 2.0, en github.com/macstab/chaos-testing.
Christian Schnapka
Macstab Engineering
Christian Schnapka desarrolla las herramientas de ingeniería abiertas detrás de Macstab. Publica las versiones extensas de estas investigaciones en Medium, con cada medición, cada salvedad y cada pérdida incluidas.