Quellcode auf GitHub
Grün auf jedem Dashboard, jeder Schreibzugriff abgewiesen
Ihr Redis läuft. Es antwortet auf PING. Die Replicas sind synchron, jedes Dashboard ist grün — und seit vierzig Minuten hat es jeden einzelnen Schreibzugriff abgelehnt.
Ein fehlgeschlagener Hintergrund-Snapshot hat gereicht. stop-writes-on-bgsave-error steht ab Werk auf yes, also weist Redis ab diesem Moment alles ab, was den Datenbestand verändert. Lesezugriffe sehen weiterhin perfekt aus. Der Master antwortet auf PING, das Einzige, was der Health-Check von Sentinel prüft — also eskaliert nichts zu ODOWN, und es wird nie ein Failover ausgelöst.
Und der Code, den Sie für den anderen Fehlerfall geschrieben haben, den echten Ausfall eines Knotens, ist noch nie gelaufen. Das ehrlich zu proben bedeutet einen Master, zwei Replicas, drei Sentinels, ein korrektes Quorum, konvergierte Replikation und einen Kill im exakt richtigen Moment. Also wird der Cache gemockt, und Ihre Client-Bibliothek sieht ihr erstes +switch-master um 03:14 Uhr in Produktion.
macstab-chaos-redis, der dritte Layer des Macstab Chaos Stack, nimmt Ihnen diese Ausrede. Darunter liegen sechs C99-LD_PRELOAD-Bibliotheken und ein JVM-Bytecode-Agent. Dieser Layer liefert, was keiner von beiden kann: eine produktionsnahe Topologie, in die sich Fehler injizieren lassen.
Eine Annotation statt neunzig Zeilen
Nach der Dependency ist eine einzige Annotation auf Klassenebene das gesamte Setup. @RedisStandalone liefert ein echtes Redis 7.4 auf einem zufälligen Port. @RedisSentinel liefert einen Master, zwei Replicas und drei Sentinels mit Quorum 2, in einem eigenen privaten Docker-Netzwerk. Kein @Testcontainers, kein statisches Container-Feld, keine @DynamicPropertySource, kein @AfterAll, das Sie schreiben wollten und nie geschrieben haben. Handles wie SentinelCluster kommen als Parameter der Testmethode an.
Das handgeschriebene Sentinel-Äquivalent umfasst etwa neunzig Zeilen und trägt Last, die der Code nirgends ausspricht: Eine bestimmte Logzeile ist der einzige Beweis, dass eine Replica fertig synchronisiert hat, Sentinel braucht eine IP statt eines Alias, und 2 000 muss den Default von 30 000 ersetzen, sonst kann keine Assertion je fertig werden. Löschen Sie eines davon, und die Tests kompilieren weiterhin. Sie fangen nur an zu lügen. Mit der Annotation steckt dieses Wissen im Framework, einmal geschrieben und durch Tests abgedeckt. Der Teardown läuft über den CloseableResource-Store von JUnit, mit dem Ryuk-Reaper von Testcontainers als unabhängigem zweiten Pfad.
// Gradle
testImplementation 'com.macstab.chaos:macstab-chaos-redis:1.0.0'

@RedisSentinel                       // 1 master + 2 replicas + 3 sentinels, quorum 2
class FailoverTest { }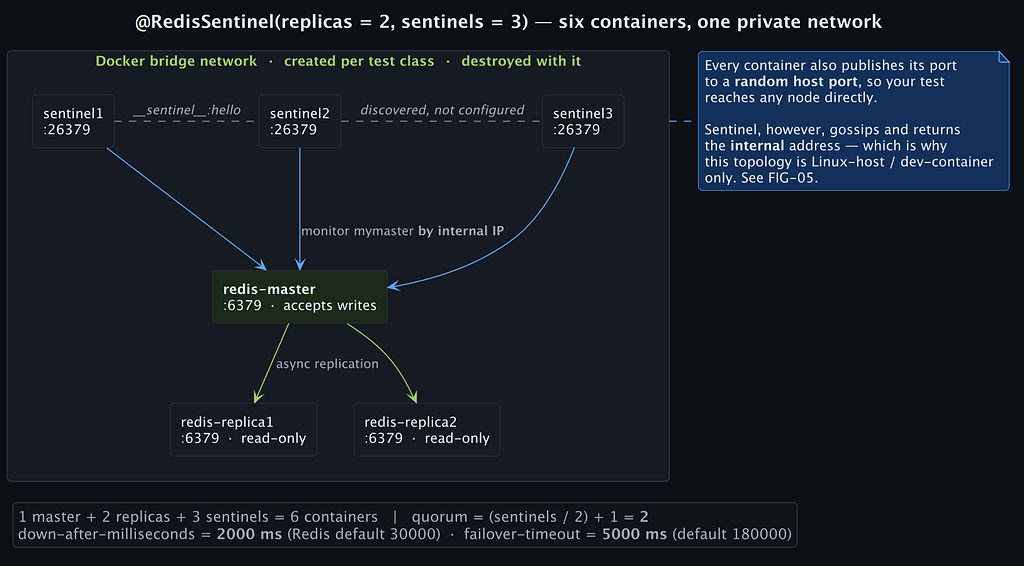
Sechs Container, in der einzigen Reihenfolge, die funktioniert
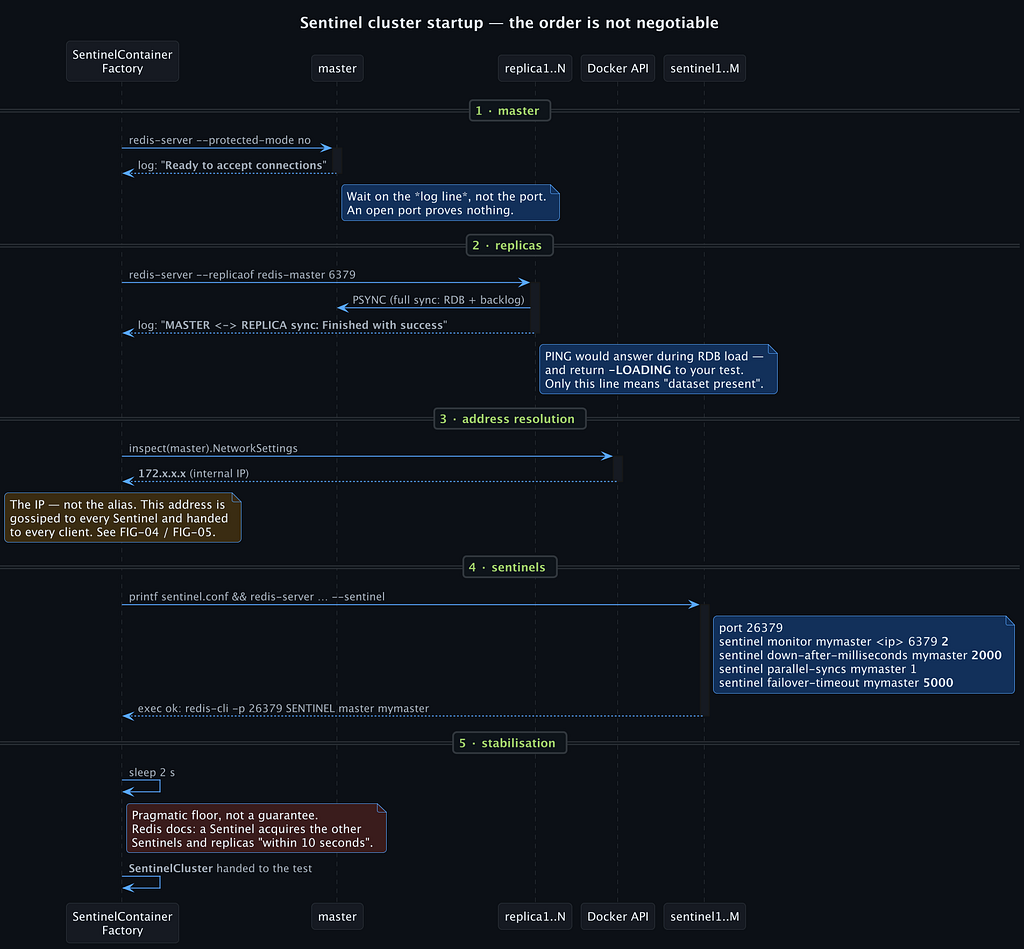
Sentinel verfolgt einen Master anhand seiner Adresse, deshalb ist die Startreihenfolge nicht verhandelbar. Vier Phasen laufen nacheinander, jede an ein semantisches Signal statt an ein Sleep gebunden: der Master an Ready to accept connections, die Replicas an MASTER <-> REPLICA sync: Finished with success, die Sentinels an ein erfolgreiches SENTINEL master mymaster, danach ein festes Stabilisierungsfenster von zwei Sekunden. Das Replica-Signal ist das wichtigste: Ein offener Port oder ein PING gelingt, während eine Replica noch das RDB lädt, und Ihr erster echter Befehl bekommt -LOADING.
Jeder Sentinel kennt nur die interne Docker-IP des Masters und entdeckt Peers und Replicas über __sentinel__:hello. Redis dokumentiert die vollständige Erkennung mit innerhalb von 10 Sekunden, die zwei Sekunden Wartezeit sind also eine pragmatische Untergrenze, kein Beweis, dass sich der Gossip gesetzt hat: Prüfen Sie, dass ein Failover abgeschlossen wird, nicht num-other-sentinels bei t=0.
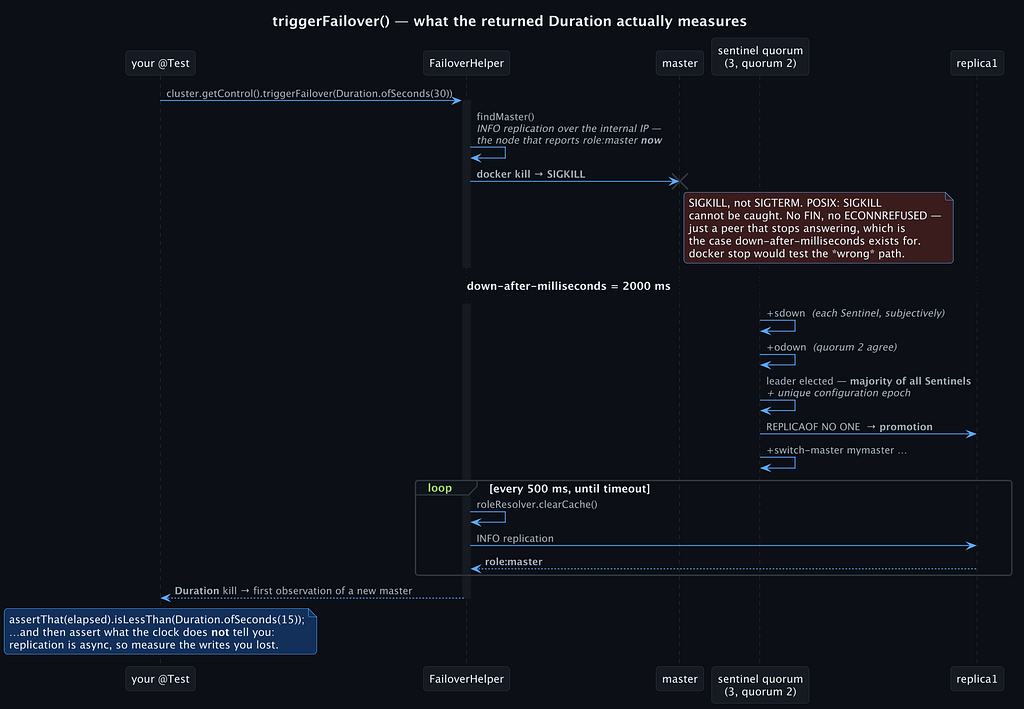
down-after-milliseconds sinkt vom Redis-Default 30 000 auf 2 000, failover-timeout von 180 000 auf 5 000. Der Default ist in Produktion richtig, wo eine GC-Pause keinen Failover auslösen soll, macht die Assertion aber innerhalb eines CI-Budgets unschreibbar. Der Preis ist ein enges Fenster: Auf einem ausgelasteten Runner kann ein Test, der prüft, dass kein Failover stattfand, flaky werden — erweitern Sie es für diese Klasse.
Quorum ist nicht die Wahlmehrheit
Das Quorum ist die Anzahl der Sentinels, die unabhängig voneinander SDOWN erreichen müssen, bevor das Urteil zu ODOWN wird — und ODOWN autorisiert lediglich einen Failover-Versuch. Durchgeführt wird er erst von einem Leader, der von einer Mehrheit aller Sentinels gewählt und über eine eindeutige Configuration Epoch versioniert wird. Quorum = 1 bei fünf Sentinels erzeugt also schnelles ODOWN und sonst nichts, wenn sich nur zwei von ihnen sehen. Die Mehrheitsregel verhindert auch, dass eine abgeschnittene Minderheit einen zweiten Master befördert. Das Modul leitet quorum = (sentinels / 2) + 1 ab und bringt ODOWN so mit der Wahlmehrheit in Deckung.
Eine scharfe Kante, benannt, bevor Sie darauf stoßen: Derzeit erreichen quorum(), version() und masterName() auf @RedisSentinel die Container-Konfiguration nicht. Die Defaults verhalten sich korrekt, aber die Konfiguration überwacht immer mymaster, und die Knoten laufen mit redis:7-alpine. Bis das durchverdrahtet ist, übergeben Sie mymaster an Ihren Client.
Nur Linux — und ehrlich damit
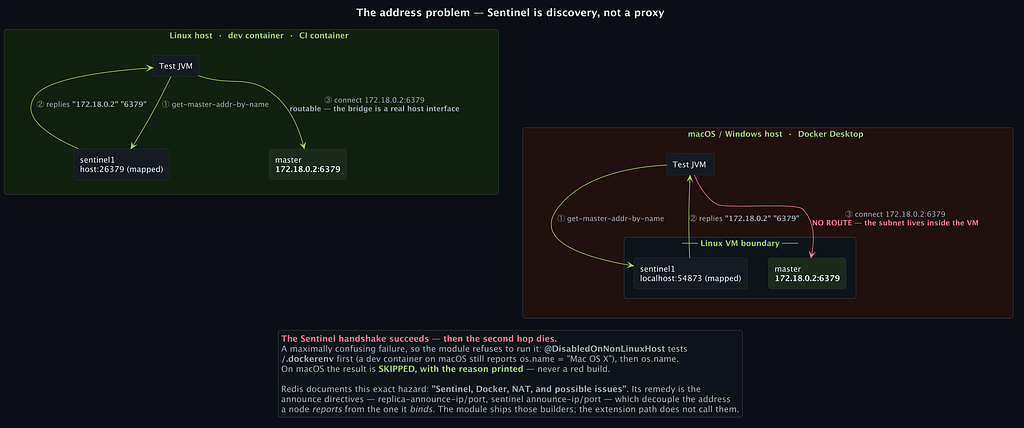
Sentinel ist ein Discovery-Protokoll, kein Proxy. Ein Sentinel-fähiger Client fragt nach dem Master, erhält die interne Adresse, etwa 172.18.0.2:6379, und verbindet sich direkt damit. Auf einem Linux-Host oder in einem Container, der das Netzwerk des Daemons teilt, ist diese Adresse routbar. Auf macOS oder Windows hält Docker Desktop die Bridge in einer VM, und jeder Sentinel-fähige Client scheitert an diesem zweiten Hop — direkt nachdem der Handshake gelungen ist.
Das Modul enthält Builder für die announce-Direktiven, die das lösen würden, doch der aktuelle Extension-Pfad ruft sie nicht auf. Deshalb trägt @RedisSentinel @DisabledOnNonLinuxHost, das zuerst auf /.dockerenv prüft und erst dann os.name, sodass ein Dev-Container auf einem Mac weiterhin läuft. Auf einem macOS-Laptop endet die Sentinel-Suite nach zwei Sekunden mit vier SKIPPED-Tests und ausgegebenem Grund. Ein roter Build, den niemand lokal beheben kann, bringt einem Team bei, rote Builds zu ignorieren; ein Skip mit Begründung hält die Suite vertrauenswürdig.
Failover als Assertion
triggerFailover() findet den Container, der gerade jetzt role:master meldet — indem es Redis über INFO replication fragt, nicht Docker — und beendet ihn mit SIGKILL. SIGTERM würde Redis seine Sockets sauber schließen lassen und die Sentinels über einen anderen, meist schnelleren Erkennungspfad schicken als ein echter Knotenausfall. Danach wird alle 500 ms gepollt, der Rollen-Cache bei jedem Durchlauf geleert, und die Duration vom Kill bis zur ersten Sichtung eines neuen Masters zurückgegeben — oder eine FailoverException mit Timeout, verstrichener Zeit und Anzahl der Versuche geworfen.
Die Uhr ist nur die halbe Wahrheit. Redis repliziert asynchron, eine Beförderung kann also das Ende des Schreibstroms verwerfen. Schreiben Sie eine monotone Sequenz, lösen Sie den Failover aus, lesen Sie sie vom neuen Master zurück und prüfen Sie den Verlust, den Sie tolerieren können. Lautet die Antwort keiner, lassen sich WAIT, min-replicas-to-write und min-replicas-max-lag auf genau dieselbe Weise testen.
@RedisSentinel(replicas = 2, sentinels = 3)
class FailoverTest {

  @Test
  void promotesWithinSlo(SentinelCluster cluster) {
    Duration elapsed = cluster.getControl().triggerFailover(Duration.ofSeconds(30));

    assertThat(elapsed).isLessThan(Duration.ofSeconds(15));
    assertThat(cluster.getControl().getMaster().isRunning()).isTrue();
  }
}
Echte Fehler auf einer echten Topologie
Mit einer echten Topologie darunter werden die unteren Layer zu Instrumenten. enableNetworkChaos = true vergibt NET_ADMIN, niemals --privileged, für tc/netem-Latenz, Jitter, Paketverlust und iptables-Partitionen. enableConnectionChaos = true lädt libchaos-net, bevor der Container startet, für errno-Injektion auf connect, send, recv und weitere Socket-Aufrufe. Beides lässt sich kombinieren: Eine Retry-Schleife verkraftet 5 % Paketverlust problemlos und scheitert trotzdem an einem einzigen ECONNRESET aus send().
Ein Uhrenversatz von zwei Sekunden oder mehr versetzt einen Sentinel in den TILT-Modus, in dem er weiter überwacht, aber nicht mehr handelt, sichtbar als sentinel_tilt in INFO. Und der Fehler vom Anfang wird reproduzierbar: Eine libchaos-io-Regel, die beim Schreiben EIO liefert, lässt den Snapshot scheitern, und die Assertion ist eine Zeile — Ihr Schreibpfad muss einen konkreten, handlungsfähigen Fehler werfen, statt Schreibzugriffe zu verlieren. Darüber bündelt macstab-chaos-testpacks-l3-redis zusammengesetzte Fehler zu benannten Incidents auf Methodenebene:
- @IncidentChaosRedisNetworkFlap: ECONNRESET auf connect und recv, was einen Wahlsturm statt eines sauberen Failovers erzeugt
- @IncidentChaosRedisFailoverStorm: ECONNREFUSED auf connect, EAI_AGAIN bei DNS-Lookups und ein CLOCK_REALTIME-Versatz
- @IncidentChaosRedisClockDrift: Uhrenversatz zwischen Knoten, Races beim TTL-Ablauf und Sentinel, der seine eigenen Timeouts falsch berechnet
- @IncidentChaosRedisOomEviction, @IncidentChaosRedisCacheAvalanche und @IncidentChaosRedisSlowlog: Eviction unter Speicherdruck, synchronisierte Ablaufstürme und Latenz auf SLOWLOG-Niveau
Key Takeaways
Einen Pod zu killen beantwortet genau eine Frage: Stirbt das System? Ein echter Sentinel-Cluster in einem JUnit-Test beantwortet die Frage, die Ihren Code tatsächlich verändert: was Ihre Client-Bibliothek während einer Beförderung tut, welche Verbindung sie noch hält, von welchem Knoten sie liest, wie viele Schreibzugriffe verloren gingen und wie lange es dauerte, das zu bemerken.
Die Grenzen stehen vorab fest: Der Redis-Cluster-Modus ist nicht abgedeckt, Sentinel läuft nur auf einem Linux-Host oder in einem Container, drei Attribute von @RedisSentinel sind noch nicht durchverdrahtet, und das Speicherbudget ist eine nominelle Leitplanke, keine Messung. Innerhalb dieser Grenzen wird ein Failover zu etwas, woran ein Pull Request rot werden kann. Das Modul heißt macstab-chaos-redis, Apache 2.0, unter github.com/macstab/chaos-testing.
Christian Schnapka
Macstab Engineering
Christian Schnapka entwickelt die offenen Engineering-Werkzeuge hinter Macstab. Die Langfassungen dieser Untersuchungen veröffentlicht er auf Medium — mit jeder Messung, jedem Vorbehalt und jedem Verlust.