Πηγαίος κώδικας στο GitHub
Το πρώτο βήμα δεν κοστίζει τίποτα
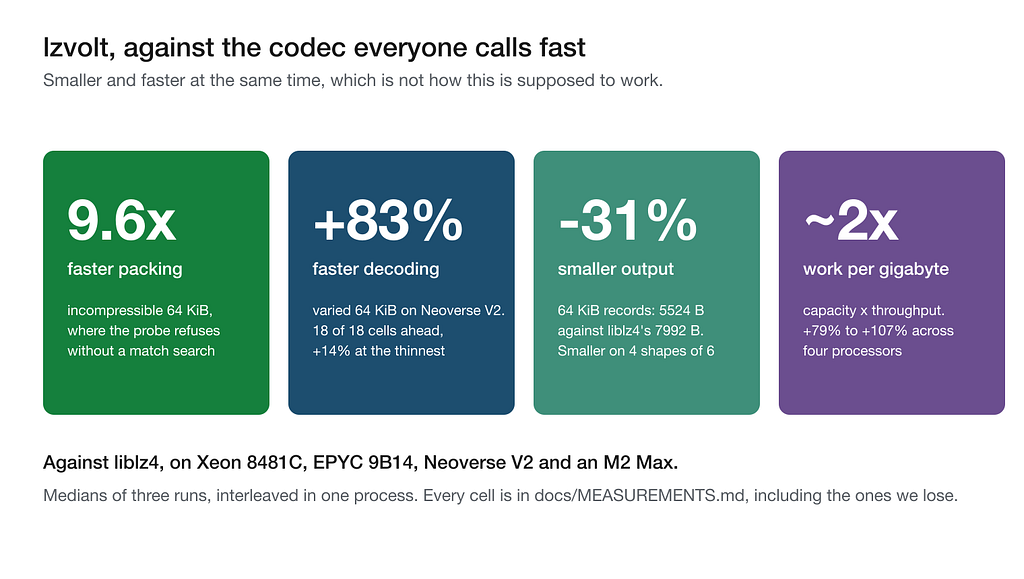
Το lzvolt διαβάζει τα ίδια τα blocks του LZ4 — όχι ένα παρόμοιο format, αλλά ακριβώς τα bytes που έγραψε το liblz4, σύμφωνα με την προδιαγραφή blocks του LZ4. Σε 20 από τις 27 μετρημένες μορφές δεδομένων τα διαβάζει ταχύτερα από το ίδιο το liblz4.
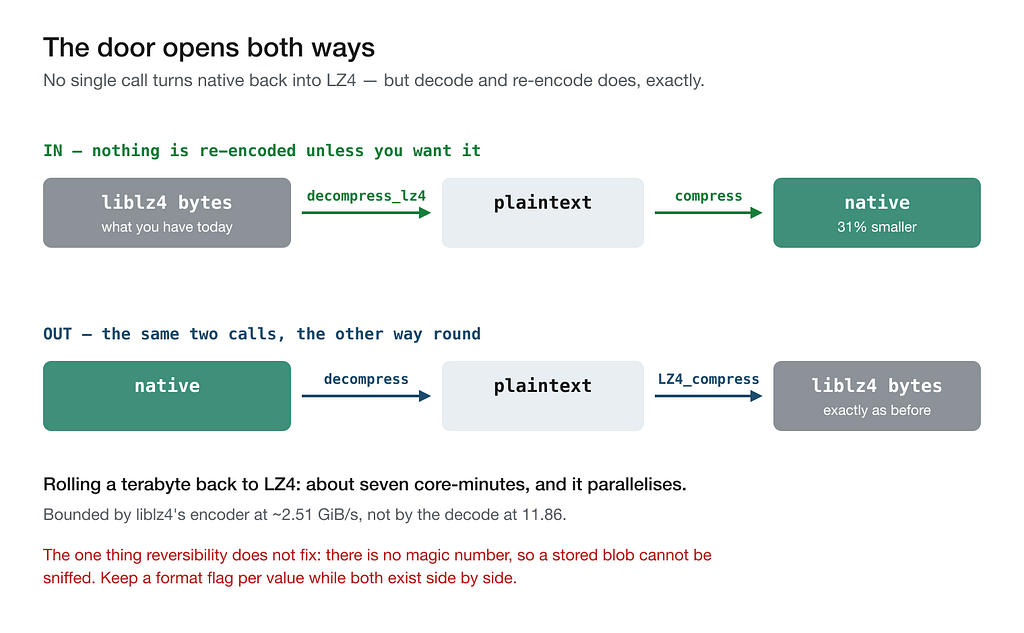
Η φθηνότερη υιοθέτηση είναι λοιπόν: κρατάτε το liblz4 ως συμπιεστή, αλλάζετε τον αποκωδικοποιητή, τέλος. Το LZ4_decompress_safe γίνεται lzvolt_decompress_lz4, με τα ίδια ορίσματα. Τα αποθηκευμένα δεδομένα δεν μετακινούνται, η διαδρομή εγγραφής μένει ανέγγιχτη και δεν υπάρχει τίποτα για επαναφορά, αφού τίποτα δεν μετατράπηκε. Για πολλά συστήματα αυτό είναι το σωστό σημείο να μείνουν — η αποκωδικοποίηση γίνεται χίλιες φορές ανά εγγραφή.
Η επανακωδικοποίηση στο εγγενές format είναι ένα δεύτερο, προαιρετικό βήμα. Εκεί βρίσκονται το 31% και ο συντελεστής δύο. Και είναι αναστρέψιμο: αποκωδικοποίηση με το νέο, συμπίεση με το παλιό. Η επιστροφή περιορίζεται από τον κωδικοποιητή του liblz4 — 2,51 GiB/s έναντι 11,86 — οπότε ένα terabyte λογικών δεδομένων επιστρέφει σε περίπου επτά λεπτά-πυρήνα.
Δύο κανόνες αν κάνετε μετατροπή. Πρώτα οι αναγνώστες: ένας αποκωδικοποιητής LZ4 απορρίπτει σωστά ένα εγγενές stream, οπότε ένα μόνο replica που δεν επανεκκινήθηκε χαλάει τη μέρα. Και όσο συνυπάρχουν τα δύο formats, κρατήστε μια σημαία ανά τιμή — σκόπιμα δεν υπάρχει magic number, άρα ένα blob δεν αναγνωρίζεται από το περιεχόμενό του.
Τι κερδίζετε: δύο οφέλη που πολλαπλασιάζονται
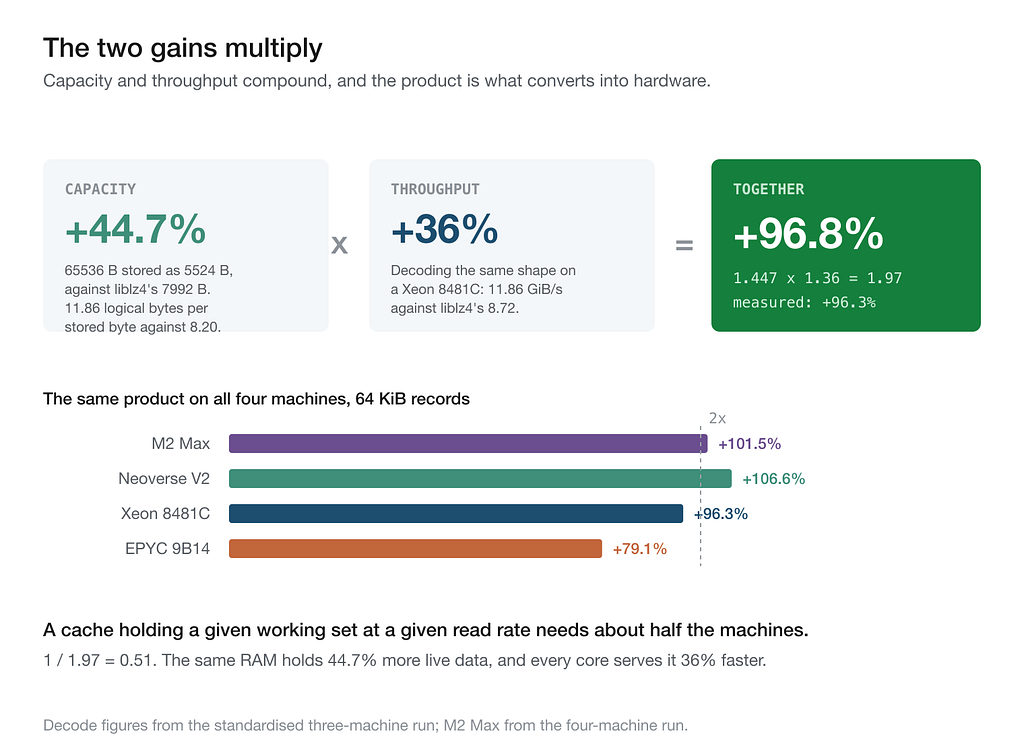
Η χωρητικότητα και η απόδοση πολλαπλασιάζονται αντί να προστίθενται: 44,7% περισσότερα ενεργά δεδομένα στην ίδια RAM και 36% ταχύτερα ανά πυρήνα. Σε εγγραφές 64 KiB το γινόμενο είναι +101,5% στο M2 Max, +106,6% στο Neoverse V2, +96,3% στον Xeon και +79,1% στον EPYC. Σε όρους προμηθειών, μια cache που κρατά ένα δεδομένο working set με δεδομένο ρυθμό ανάγνωσης χρειάζεται περίπου τα μισά μηχανήματα.
Ούτε περιορίζεται στη μορφή που συμπιέζεται καλύτερα. Σε ποικίλα δεδομένα 64 KiB η χωρητικότητα είναι 1,4% χειρότερη από του LZ4, και ο συνδυασμός παραμένει από +62% έως +89%, χάρη μόνο στην αποκωδικοποίηση.
Επιπλέον, τα μεγέθη μου περιλαμβάνουν μια κεφαλίδα μήκους, ενώ τα γυμνά blocks του LZ4 δεν φέρουν καθόλου μήκος. Μια αυτόνομη τιμή LZ4 σημαίνει το frame format, που κοστίζει σταθερά 23 bytes. Το ένα κελί εγγραφών που χάνω — 512 bytes, κατά 1,6% — το κερδίζω κατά 9,3% απέναντι σε μια αυτοτελή τιμή LZ4.
Πώς γίνεται: τρεις αποφάσεις για τα bits
Κανένας νέος αλγόριθμος. LZ77 με τα ίδια δύο βασικά στοιχεία που χρησιμοποιούν όλοι, ακολουθίες literals και αναφορές προς τα πίσω, συν τρεις αποφάσεις για το πώς ξοδεύονται τα bits, τις οποίες οι συνήθεις υλοποιήσεις δεν παίρνουν.
Δύο μορφές token. Το token του LZ4 είναι ένα byte: τέσσερα bits για το μήκος των literals, τέσσερα για το μήκος του match. Σε ποικίλες εγγραφές 4 KiB, το 49% των μηκών match πέφτει κάτω από το όριο των τεσσάρων bits και το 47% πάνω από αυτό — ακριβώς πάνω στη γραμμή, οπότε το καθοριστικό branch αλλάζει συνεχώς κατεύθυνση και ο predictor είναι άχρηστος. Γι' αυτό το format έχει δύο διατάξεις, και ένα stream μπορεί να αλλάξει από τη μία στην άλλη ακριβώς μία φορά. Η ευρεία διάταξη ανταλλάσσει δύο bits literals με ένα πέμπτο bit match, μεταφέροντας το escape από τα 19 στα 35 bytes, συν ένα bit για σημαία επανάληψης: ίδιο offset με την προηγούμενη φορά.
Το μήκος ζει μέσα στο stream. Μια κεφαλίδα ενός έως τεσσάρων bytes, δομημένη όπως οι ακέραιοι μεταβλητού μήκους του QUIC, φέρει το αποκωδικοποιημένο μήκος, και η συντομότερη κωδικοποίηση είναι υποχρεωτική. Ο αποκωδικοποιητής δεσμεύει μνήμη μία φορά, ακριβώς, και αντιμετωπίζει την περικοπή ως σφάλμα αντί για μια εύλογη σύντομη απάντηση.
Ο συμπιεστής αρνείται. Ένας γρήγορος έλεγχος παρακάμπτει τα μη επαναλαμβανόμενα δεδομένα χωρίς να τρέξει αναζήτηση match, και ένα κατώφλι ενός ογδόου αποφασίζει τα υπόλοιπα. Κάτω από αυτό, η τιμή αποθηκεύεται ακατέργαστη και το compress επιστρέφει false, επειδή η ανάγνωση μιας συμπιεσμένης τιμής κοστίζει τέσσερις έως πέντε φορές περισσότερο από την ανάγνωση μιας αποθηκευμένης. Το liblz4 δεν έχει τέτοιο βήμα.
saved >= 8 && saved * 8 >= original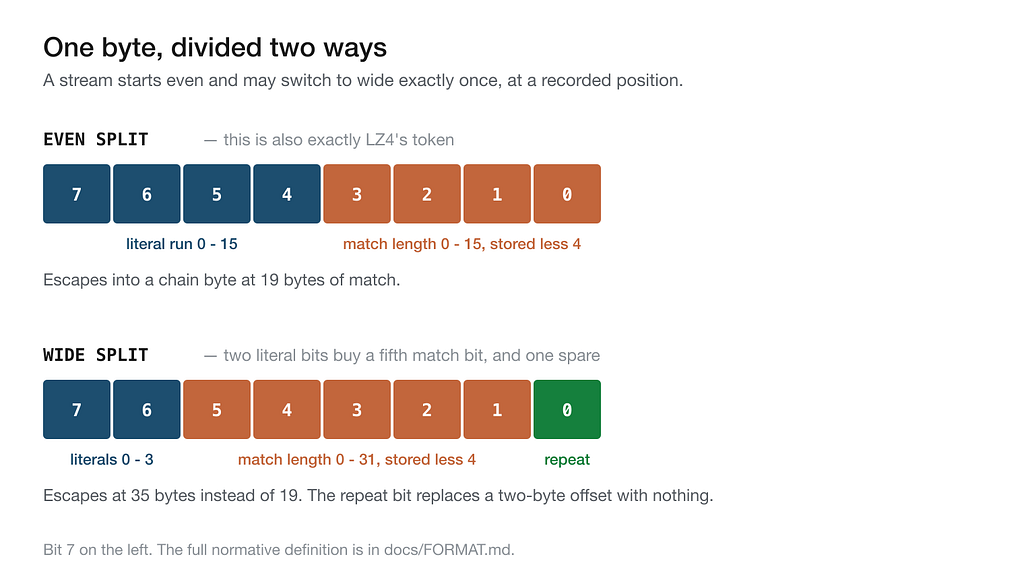
Γιατί είναι γρήγορο
Ένας αποκωδικοποιητής είναι ένας βρόχος πάνω στην είσοδό του. Σε εγγραφές 64 KiB ο δικός μου διατρέχει 5524 bytes εκεί που το liblz4 διατρέχει 7992, για τα ίδια 65536 bytes εξόδου. Δώστε σε έναν βρόχο 31% λιγότερη είσοδο και θα έχετε κάνει 31% λιγότερο σχεδόν τα πάντα. Το κέρδος μεγέθους και το κέρδος ταχύτητας είναι ένα αποτέλεσμα, μετρημένο δύο φορές.
Τρεις ακόμη μηχανισμοί. Το ένα τρίτο των blocks δεν φορτώνει ποτέ offset — 493 από τα 1567 φέρουν τη σημαία επανάληψης. Ένα μόνο load 32 bits φέρνει token, offset και μήκος match όταν η ακολουθία literals είναι κενή: στο 56% των blocks σε ποικίλα 4 KiB, στο 88% σε εγγραφές 64 KiB. Και πάνω από ένα κατώφλι, το memcpy νικά έναν χειρόγραφο βρόχο, επειδή αυτό της glibc το βελτιστοποιούν άνθρωποι που δεν κάνουν τίποτε άλλο.
Ο πυρήνας περιορίζεται από την καθυστέρηση, όχι από την έκδοση εντολών: ο βρόχος αντιγραφής τρέχει με IPC 5,37 έναντι πλάτους έκδοσης έξι. Η αφαίρεση μιας εντολής δεν αποφέρει τίποτα· η αφαίρεση ενός εξαρτημένου load από την κρίσιμη αλυσίδα αποφέρει τρεις κύκλους.
Μια ειλικρινής επιφύλαξη: δεν έχω απενεργοποιήσει και μετρήσει χωριστά αυτούς τους μηχανισμούς. Οι επιμέρους αριθμοί είναι μετρημένοι· η κατάταξή τους είναι συμπέρασμα, όχι μετρημένη ανάλυση.
Οι αριθμοί, και τι δεν ισχυρίζομαι
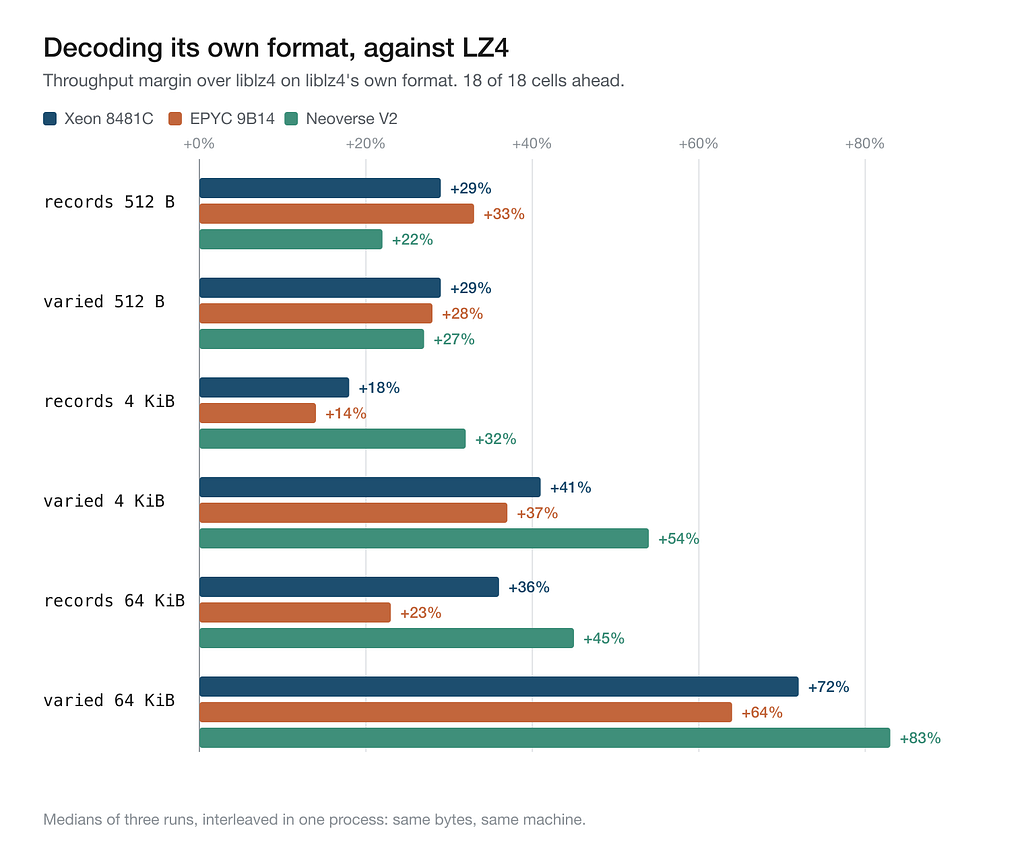
Τρία μηχανήματα, τρεις εκτελέσεις το καθένα, διάμεσος τριών, εναλλάξ με το liblz4 μέσα σε μία διεργασία — ίδια bytes, ίδιο μηχάνημα, ίδιο λεπτό. Αποκωδικοποίηση του εγγενούς format: δεκαοκτώ κελιά, δεκαοκτώ νίκες, από +14% έως +83%. Στην ανάγνωση των ίδιων των blocks του LZ4 κερδίζει 20 από 27· οι επτά ήττες συγκεντρώνονται σε μικρές, μη συμπιέσιμες τιμές σε x86, όπου υστερώ κατά 12–15%.
Σε μέγεθος, τέσσερις από τις έξι μορφές είναι μικρότερες από ό,τι με το LZ4 και δύο μεγαλύτερες: τα ποικίλα 64 KiB κατά 1,4%, οι εγγραφές 512 bytes κατά 1,6%. Το liblz4 είναι το τυπικό πακέτο της διανομής, ενώ από τη δική μου πλευρά υπάρχει χειρόγραφο assembly που επιλέγεται ανά σειρά επεξεργαστή — έντιμο για την παραγωγή, αλλά όχι σύγκριση ίσης προσπάθειας. Ο governor της CPU, το turbo και η δέσμευση πυρήνων δεν ελέγχθηκαν, οπότε αντιμετωπίστε τις μονοψήφιες διαφορές με καχυποψία.
Ο codec περιλαμβάνει πέντε ξεχωριστά συναρμολογημένα σώματα αποκωδικοποιητή, επειδή ίδιες αλλαγές μετρήθηκαν με αντίθετο πρόσημο σε διαφορετικούς επεξεργαστές: η ευθυγράμμιση της πηγής πριν από την αντιγραφή δίνει +49% στο Neoverse V2 και −7,1% στο M2 Max, και τα δύο aarch64. Ένας αριθμός benchmark χωρίς όνομα μηχανήματος είναι θόρυβος.
Μέτρησα απέναντι στο liblz4 και στο lz4_flex — όχι απέναντι στο Selkie της Oodle, στο lzturbo, στο Snappy, στο LZO ή στο zstd σε αρνητικά επίπεδα. Άρα, με ακρίβεια: στο format που τυποποίησε η βιομηχανία, σε τέσσερις επεξεργαστές, το LZ4 δεν είναι πια το ταχύτερο που το διαβάζει. Αυτό είναι όλο όσο στηρίζουν οι αριθμοί.
Τι δεν εντόπισαν τα πράσινα tests
Περίπου είκοσι σκόπιμες αλλαγές έδωσαν μηδενικό ή αρνητικό αποτέλεσμα. Τρεις κράτησαν το έργο, και και οι τρεις αφαίρεσαν δουλειά αντί να κάνουν φθηνότερη την υπάρχουσα.
Το harness μέτρησης είπε ψέματα τέσσερις φορές, την τελευταία λόγω aliasing 4 KiB: ίδιο binary, 32% διαφορά, επειδή το malloc τοποθετούσε τους buffers διαφορετικά σε κάθε διεργασία. Τώρα χρησιμοποιεί μία arena με σταθερά offsets, παίρνει τη διάμεσο πέντε λόγων και τυπώνει ένα όριο ανάλυσης 6% ανά κελί.
Τρία bugs επέζησαν από πράσινες σουίτες tests, ανάμεσά τους ένας αποκωδικοποιητής που εκτελούσε 512 bytes του δικού του πίνακα αναζήτησης ως κώδικα μηχανής, και μια παραβίαση provenance που βρήκε μόνο το Miri. Κάθε test ξεκινούσε από ένα stream που είχε γράψει ο συμπιεστής· ένας επιτιθέμενος δεν έχει τέτοιον περιορισμό. Πλέον οι αλλαγές στο assembly γίνονται δεκτές μόνο αφού μια σκόπιμη αλλοίωση κάνει τη σουίτα κόκκινη, και τέσσερα targets του cargo-fuzz έτρεξαν 115.090.390 εκτελέσεις υπό AddressSanitizer χωρίς κατάρρευση — κάτι που δεν αποτελεί απόδειξη απουσίας.
Το βαθύτερο δίδαγμα: κάθε πρόβλημα της τελευταίας στιγμής ήταν ένας ισχυρισμός για τον κώδικα που κανείς δεν είχε εκτελέσει. Εκτελέστε την πρόταση πριν τη γράψετε.
Key Takeaways
Το lzvolt = "1.0" απαιτεί rustc 1.85 ή νεότερο, και το release περιλαμβάνει προμεταγλωττισμένες βιβλιοθήκες .so, .dylib και .dll με κεφαλίδα C για Linux, macOS και Windows σε amd64 και arm64. Στα Windows τρέχει το φορητό Rust αντί για το assembly και είναι πιο αργό· το API αναφέρει ποια διαδρομή χρησιμοποιείτε.
Ξεκινήστε με make quick: περίπου επτά δευτερόλεπτα, και τυπώνει το όνομα του επεξεργαστή σας και ένα συμπέρασμα. Έπειτα στρέψτε το lzvolt_decompress_lz4 σε blocks που ήδη έχετε, αφήστε το liblz4 να συνεχίσει τη συμπίεση και συγκρίνετε. Τίποτα επανακωδικοποιημένο, τίποτα μεταφερμένο — ένα απόγευμα για να μάθετε αν κάνω λάθος. Το format έχει κανονιστική προδιαγραφή και 16 διανύσματα δοκιμών για αποκωδικοποιητές, και το ημερολόγιο μετρήσεων στο repository περιέχει κάθε αριθμό και και τις είκοσι διαψεύσεις.
Christian Schnapka
Macstab Engineering
Ο Christian Schnapka αναπτύσσει τα ανοιχτά εργαλεία μηχανικής πίσω από τη Macstab. Δημοσιεύει τις εκτενείς εκδοχές αυτών των ερευνών στο Medium — με κάθε μέτρηση, κάθε επιφύλαξη και κάθε ήττα.