Broncode op GitHub
Stap één kost niets
lzvolt leest de eigen blokken van LZ4 — geen vergelijkbaar formaat, maar precies de bytes die liblz4 heeft geschreven, volgens de LZ4-blokspecificatie. Op 20 van de 27 gemeten vormen leest het ze sneller dan liblz4 zelf.
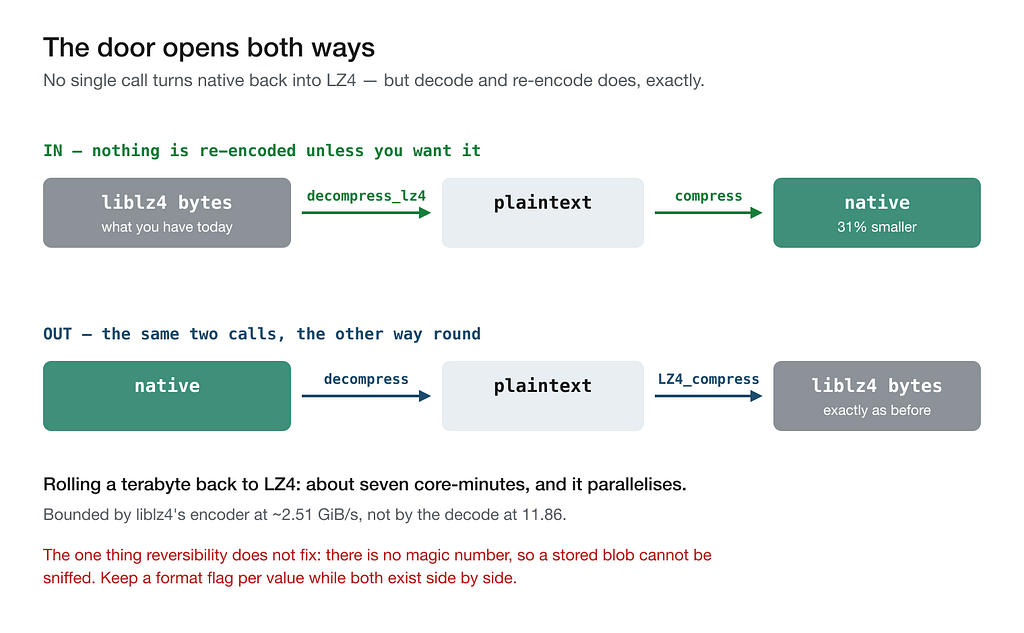
De goedkoopste adoptie is dus: liblz4 als packer houden, de decoder vervangen, klaar. LZ4_decompress_safe wordt lzvolt_decompress_lz4, met dezelfde argumenten. Opgeslagen data verplaatst niet, het schrijfpad blijft onaangeroerd en er valt niets terug te draaien, omdat niets is geconverteerd. Voor veel systemen is dat de juiste plek om te blijven — er wordt duizend keer gedecodeerd per schrijfactie.
Hercoderen naar het native formaat is een tweede, optionele stap. Daar zitten de 31% en de factor twee. En die stap is omkeerbaar: decoderen met de nieuwe, packen met de oude. De terugweg wordt begrensd door de encoder van liblz4 — 2,51 GiB/s tegenover 11,86 — zodat een terabyte aan logische data in ongeveer zeven core-minuten is teruggedraaid.
Twee regels als u converteert. Eerst de lezers: een LZ4-decoder weigert een native stream terecht, dus één niet-herstarte replica verpest de dag. En zolang beide formaten naast elkaar bestaan, houdt u per waarde een vlag bij — er is bewust geen magic number, dus een blob is niet aan de inhoud te herkennen.
Wat u krijgt: twee winsten die zich vermenigvuldigen
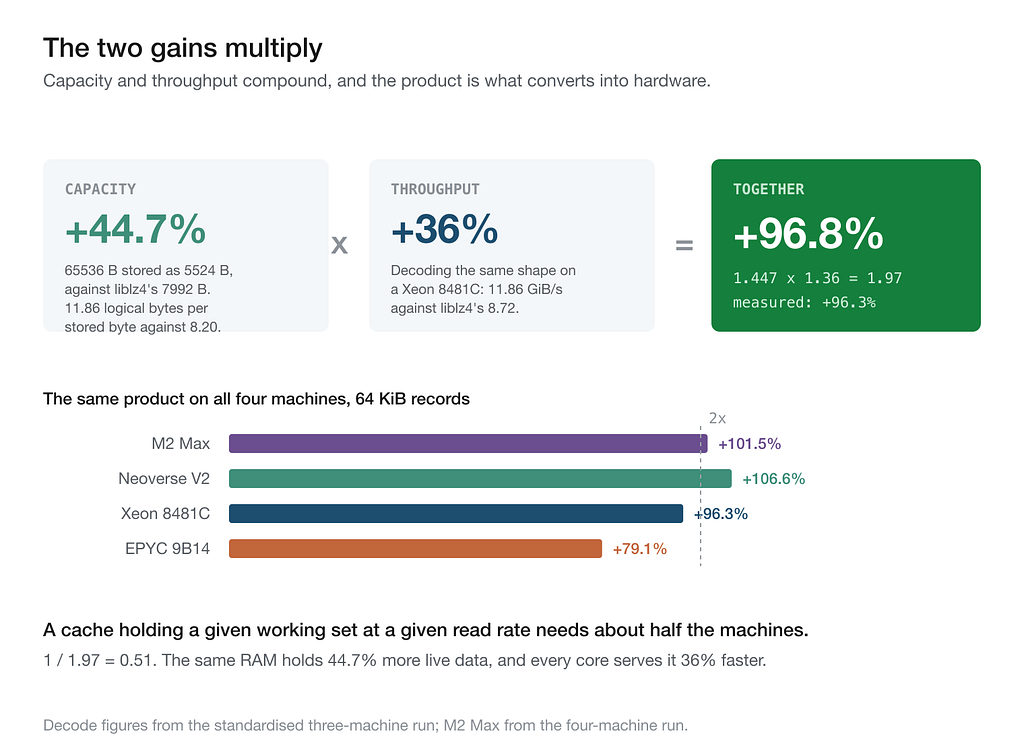
Capaciteit en doorvoer vermenigvuldigen zich in plaats van op te tellen: 44,7% meer live data in hetzelfde RAM en 36% sneller per core. Op records van 64 KiB is dat product +101,5% op de M2 Max, +106,6% op Neoverse V2, +96,3% op Xeon en +79,1% op EPYC. In inkooptermen: een cache die een gegeven working set bij een gegeven leessnelheid vasthoudt, heeft ongeveer de helft van de machines nodig.
Het blijft ook niet beperkt tot de best comprimeerbare vorm. Op gevarieerde data van 64 KiB is de capaciteit 1,4% slechter dan bij LZ4, en de combinatie ligt nog steeds op +62% tot +89%, alleen gedragen door het decoderen.
Bovendien bevatten mijn groottes een lengte-header, terwijl de kale blokken van LZ4 helemaal geen lengte meedragen. Een op zichzelf staande LZ4-waarde betekent het frame-formaat, en dat kost vast 23 bytes. De ene record-cel die ik verlies — 512 bytes, met 1,6% — win ik met 9,3% tegen een zelfstandige LZ4-waarde.
Hoe het werkt: drie beslissingen over bits
Geen nieuw algoritme. LZ77 met dezelfde twee primitieven die iedereen gebruikt, literal-runs en terugverwijzingen, plus drie beslissingen over het besteden van bits die de gangbare implementaties niet nemen.
Twee tokenvormen. Het token van LZ4 is één byte: vier bits literal-lengte, vier bits match-lengte. Op gevarieerde records van 4 KiB valt 49% van de match-lengtes onder het plafond van vier bits en 47% erboven — er pal overheen, zodat de beslissende branch steeds van richting wisselt en de predictor nutteloos is. Het formaat kent daarom twee lay-outs, en een stream mag precies één keer tussen beide wisselen. De brede lay-out ruilt twee literal-bits in voor een vijfde match-bit, waardoor de escape van 19 naar 35 bytes schuift, plus één bit voor een repeat-vlag: dezelfde offset als de vorige keer.
De lengte zit in de stream. Een header van één tot vier bytes, opgebouwd zoals de variable-length integers van QUIC, draagt de gedecodeerde lengte, en de kortste codering is verplicht. De decoder alloceert één keer, exact, en behandelt afkapping als een fout in plaats van als een plausibel kort antwoord.
De packer weigert. Een snelle probe slaat niet-repetitieve data over zonder een match-zoektocht te starten, en een drempel van een achtste beslist de rest. Daaronder wordt de waarde ruw opgeslagen en geeft compress false terug, omdat het lezen van een gepackte waarde vier tot vijf keer zoveel kost als het lezen van een opgeslagen waarde. liblz4 kent zo'n stap niet.
saved >= 8 && saved * 8 >= original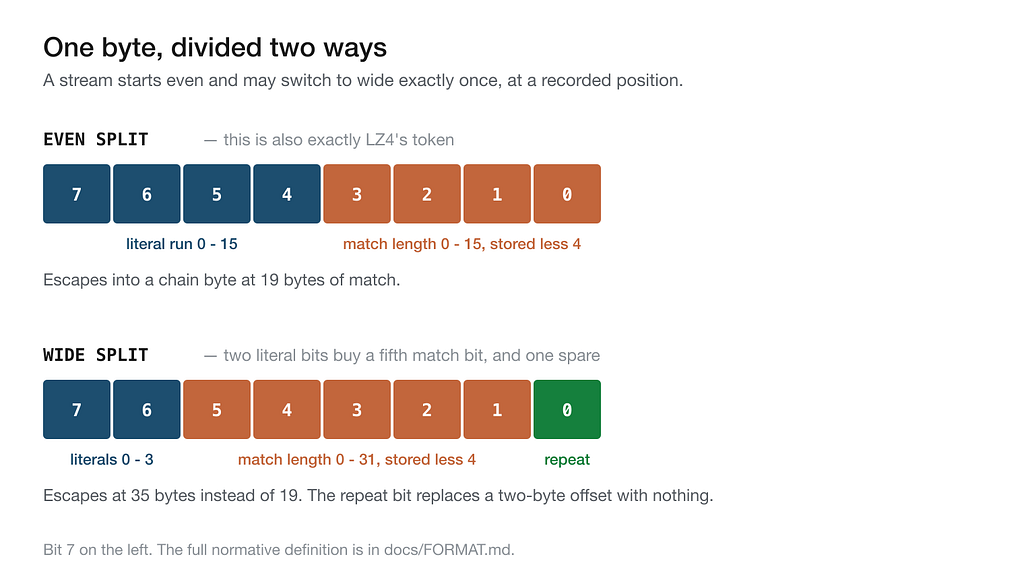
Waarom het snel is
Een decoder is een lus over zijn invoer. Op records van 64 KiB doorloopt de mijne 5524 bytes waar liblz4 er 7992 doorloopt, voor dezelfde 65536 bytes uitvoer. Geef een lus 31% minder invoer en u hebt 31% minder van bijna alles gedaan. De groottewinst en de snelheidswinst zijn één resultaat, twee keer gemeten.
Nog drie mechanismen. Een derde van de blokken laadt nooit een offset — 493 van de 1567 dragen de repeat-vlag. Eén enkele 32-bit-load levert token, offset en match-lengte wanneer de literal-run leeg is: 56% van de blokken op gevarieerde 4 KiB, 88% op records van 64 KiB. En boven een drempel verslaat memcpy een handgeschreven lus, omdat die van glibc wordt getuned door mensen die niets anders doen.
De kernel is latency-gebonden, niet issue-gebonden: de kopieerlus draait op een IPC van 5,37 bij een issue-breedte van zes. Een instructie schrappen levert niets op; een afhankelijke load uit de kritieke keten schrappen levert drie cycli op.
Eén eerlijk voorbehoud: ik heb deze mechanismen niet afzonderlijk uitgeschakeld en gemeten. De afzonderlijke getallen zijn gemeten; hun rangorde is een afleiding, geen gemeten ontleding.
De cijfers, en wat ik niet beweer
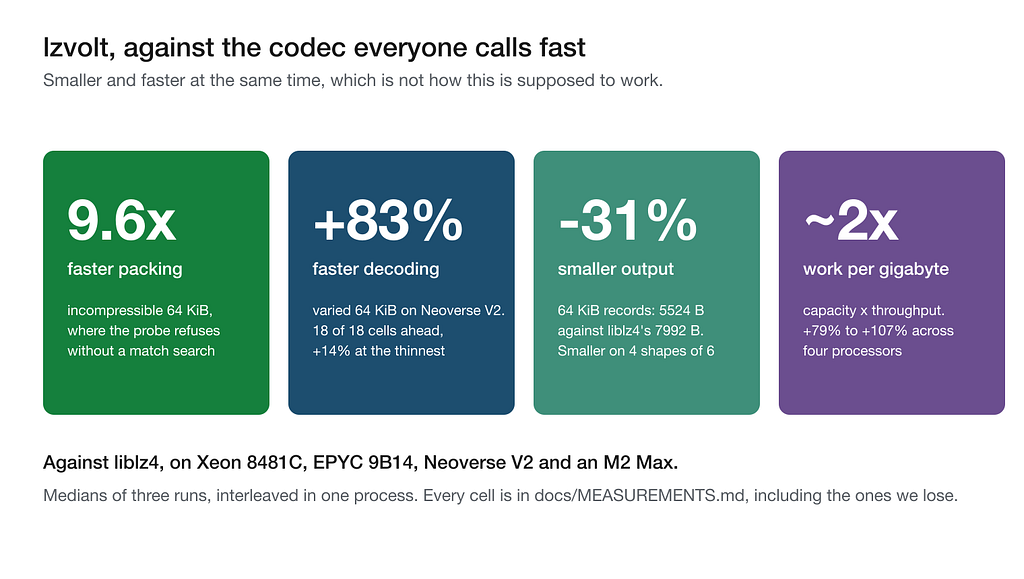
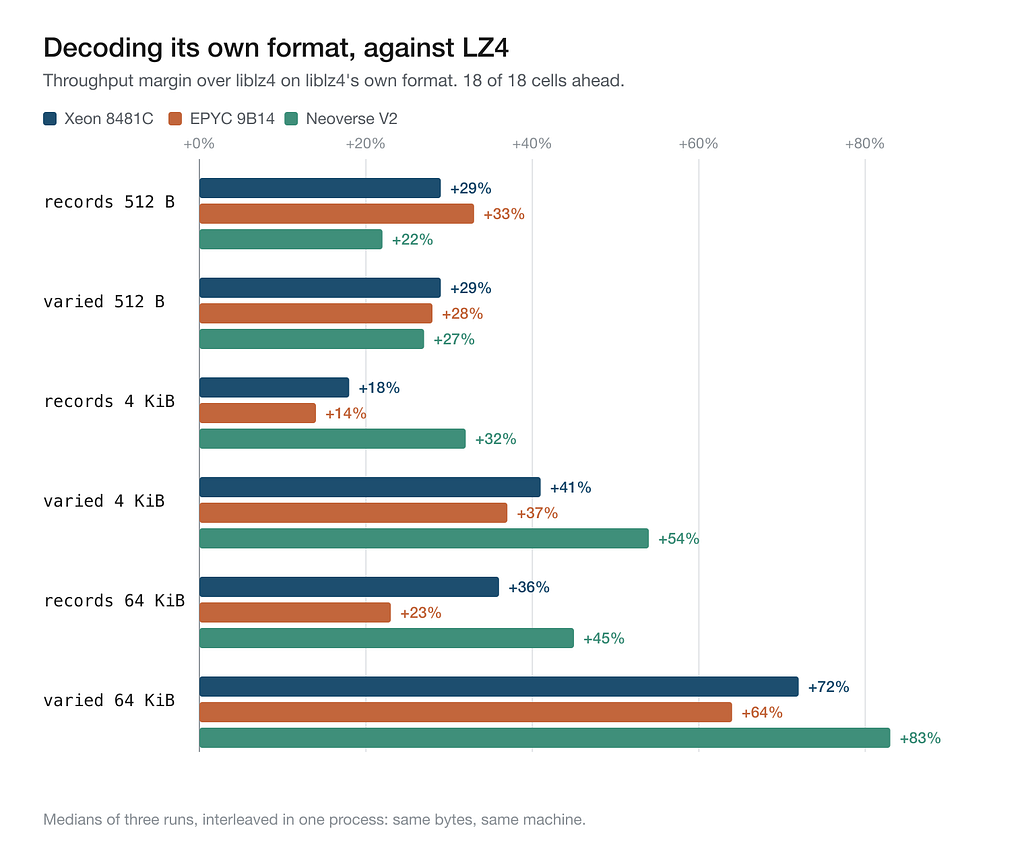
Drie machines, elk drie runs, mediaan van drie, verweven met liblz4 in één proces — dezelfde bytes, dezelfde machine, dezelfde minuut. Decoderen van het native formaat: achttien cellen, achttien overwinningen, +14% tot +83%. Bij het lezen van de eigen blokken van LZ4 wint het 20 van de 27; de zeven verliezen clusteren op kleine, niet-comprimeerbare waarden op x86, waar ik 12–15% inlever.
Qua grootte zijn vier van de zes vormen kleiner dan bij LZ4 en twee groter: gevarieerde 64 KiB met 1,4%, records van 512 bytes met 1,6%. liblz4 is het standaardpakket van de distributie, terwijl mijn kant handgeschreven assembly is die per processorlijn wordt gekozen — eerlijk voor de praktijk, maar geen vergelijking van gelijke inspanning. CPU-governor, turbo en core-pinning werden niet gecontroleerd, dus bekijk marges van één cijfer met argwaan.
De codec levert vijf afzonderlijk geassembleerde decoder-bodies, omdat identieke wijzigingen op verschillende processors met tegengesteld teken werden gemeten: de bron uitlijnen vóór het kopiëren levert +49% op Neoverse V2 en −7,1% op de M2 Max, beide aarch64. Een benchmarkgetal zonder machinenaam is ruis.
Ik heb gemeten tegen liblz4 en lz4_flex — niet tegen Selkie van Oodle, lzturbo, Snappy, LZO of zstd op negatieve niveaus. Dus, precies: op het formaat waarop de industrie heeft gestandaardiseerd, over vier processors, is LZ4 niet langer het snelste dat het leest. Meer ondersteunen de cijfers niet.
Wat groene tests niet vonden
Ongeveer twintig bewuste wijzigingen leverden nul of een negatief resultaat op. Drie droegen het project, en alle drie schrapten werk in plaats van bestaand werk goedkoper te maken.
Het meetharnas heeft vier keer gelogen, de laatste keer door 4 KiB-aliasing: hetzelfde binary, 32% verschil, omdat malloc de buffers in elk proces anders plaatste. Nu gebruikt het één arena met vaste offsets, neemt het de mediaan van vijf verhoudingen en toont het per cel een resolutiegrens van 6%.
Drie bugs overleefden groene testsuites, waaronder een decoder die 512 bytes van zijn eigen lookup-tabel als machinecode uitvoerde, en een provenance-schending die alleen Miri vond. Elke test begon met een stream die de packer had geschreven; een aanvaller heeft die beperking niet. Wijzigingen aan de assembly worden nu pas geaccepteerd nadat een bewuste beschadiging de suite rood heeft gemaakt, en vier cargo-fuzz-targets draaiden 115.090.390 uitvoeringen onder AddressSanitizer zonder crash — geen bewijs van afwezigheid.
De eigenlijke les: elk laat probleem was een bewering over de code die niemand had uitgevoerd. Voer de zin uit voordat u hem opschrijft.
Key Takeaways
lzvolt = "1.0" vereist rustc 1.85 of nieuwer, en de release bevat voorgebouwde .so-, .dylib- en .dll-bibliotheken met een C-header voor Linux, macOS en Windows op amd64 en arm64. Windows draait de portable Rust in plaats van de assembly en is trager; de API meldt welk pad u hebt gekregen.
Begin met make quick: ongeveer zeven seconden, en het toont de naam van uw processor en een oordeel. Richt daarna lzvolt_decompress_lz4 op blokken die u al hebt, laat liblz4 verder packen en vergelijk. Niets opnieuw gecodeerd, niets gemigreerd — een middag om uit te vinden of ik het mis heb. Het formaat heeft een normatieve specificatie en 16 decoder-testvectoren, en het meetlogboek in de repository bevat elk getal en alle twintig weerleggingen.
Christian Schnapka
Macstab Engineering
Christian Schnapka bouwt de open engineeringtools achter Macstab. De lange versies van deze onderzoeken publiceert hij op Medium — elke meting, elk voorbehoud en elk verlies inbegrepen.