Código fuente en GitHub
El primer paso no cuesta nada
lzvolt lee los bloques propios de LZ4: no un formato parecido, sino exactamente los bytes que escribió liblz4, según la especificación de bloques de LZ4. En 20 de 27 perfiles medidos los lee más rápido que el propio liblz4.
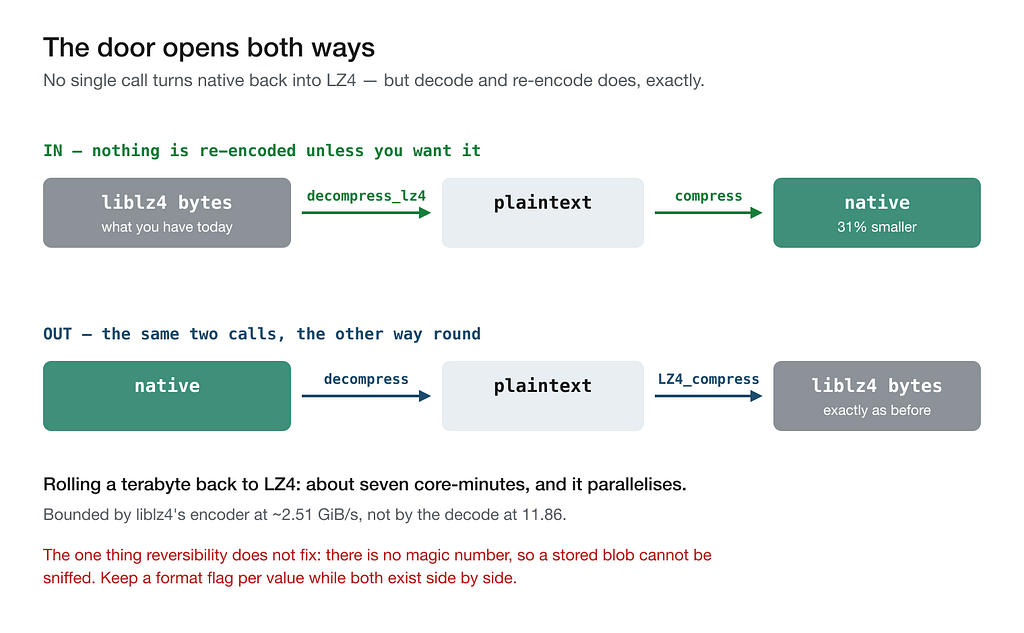
Así que la adopción más barata es: mantener liblz4 como compresor, cambiar el decodificador y nada más. LZ4_decompress_safe pasa a ser lzvolt_decompress_lz4, con los mismos argumentos. Los datos almacenados no se mueven, la ruta de escritura no se toca y no hay nada que revertir porque nada se ha convertido. Para muchos sistemas ese es el lugar correcto donde quedarse: se decodifica mil veces por cada escritura.
Recodificar al formato nativo es un segundo paso opcional. Ahí están el 31 % y el factor dos. Y es reversible: decodificar con el nuevo, comprimir con el antiguo. El viaje de vuelta está limitado por el codificador de liblz4 —2,51 GiB/s frente a 11,86—, de modo que un terabyte de datos lógicos se revierte en unos siete minutos-núcleo.
Dos reglas si convierte. Primero los lectores: un decodificador LZ4 rechaza correctamente un flujo nativo, así que una sola réplica sin reiniciar arruina el día. Y mientras ambos formatos convivan, guarde un indicador por valor: deliberadamente no hay número mágico, así que un blob no puede identificarse por su contenido.
Lo que obtiene: dos ganancias que se multiplican
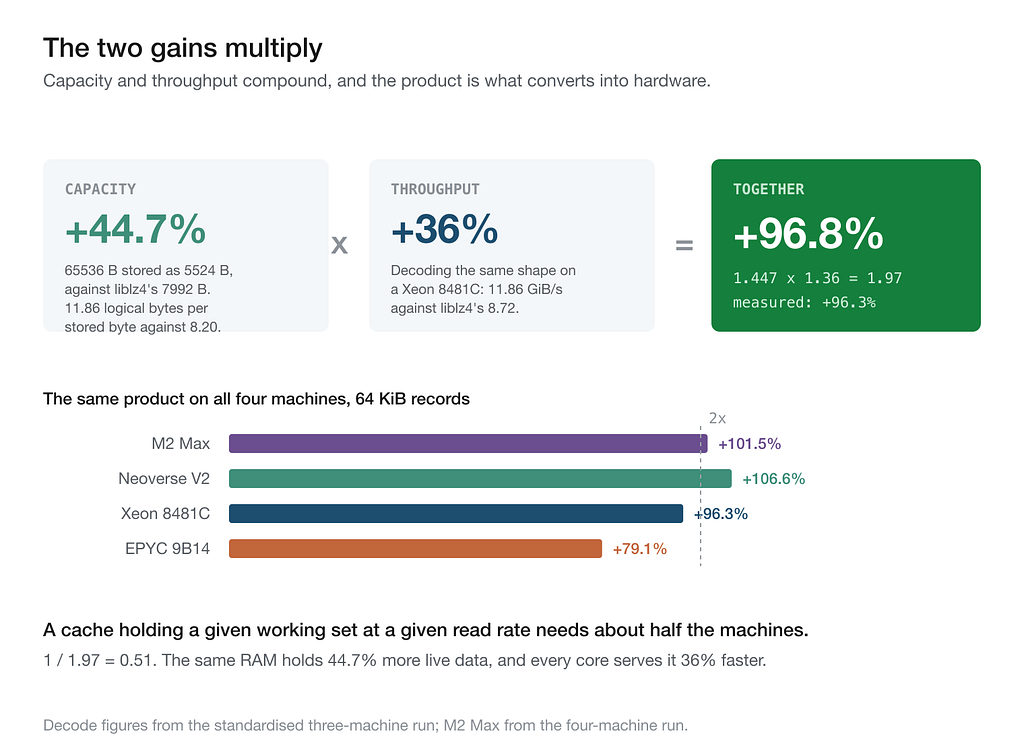
Capacidad y rendimiento se multiplican en lugar de sumarse: un 44,7 % más de datos vivos en la misma RAM y un 36 % más rápido por núcleo. Con registros de 64 KiB ese producto es +101,5 % en el M2 Max, +106,6 % en Neoverse V2, +96,3 % en Xeon y +79,1 % en EPYC. En términos de compras, una caché que mantiene un working set dado a una tasa de lectura dada necesita aproximadamente la mitad de máquinas.
Tampoco se limita al perfil que mejor se comprime. Con datos variados de 64 KiB la capacidad es un 1,4 % peor que la de LZ4, y la combinación sigue siendo de +62 % a +89 %, sostenida solo por la decodificación.
Además, mis tamaños incluyen una cabecera de longitud, mientras que los bloques desnudos de LZ4 no llevan ninguna longitud. Un valor LZ4 independiente implica el formato frame, que cuesta 23 bytes fijos. La única celda de registros que pierdo —512 bytes, por un 1,6 %— la gano por un 9,3 % frente a un valor LZ4 autocontenido.
Cómo se hace: tres decisiones sobre bits
No hay un algoritmo nuevo. LZ77 con las mismas dos primitivas que usa todo el mundo, secuencias de literales y referencias hacia atrás, más tres decisiones sobre cómo gastar bits que las implementaciones habituales no toman.
Dos formas de token. El token de LZ4 ocupa un byte: cuatro bits de longitud de literales y cuatro de longitud de coincidencia. En registros variados de 4 KiB, el 49 % de las longitudes de coincidencia queda por debajo del techo de cuatro bits y el 47 % por encima, a caballo, de modo que la rama decisiva cambia de dirección constantemente y el predictor no sirve. Por eso el formato tiene dos disposiciones, y un flujo puede cambiar entre ellas exactamente una vez. La disposición ancha cambia dos bits de literales por un quinto bit de coincidencia, lo que lleva el escape de 19 a 35 bytes, más un bit para un indicador de repetición: el mismo offset que la última vez.
La longitud vive en el flujo. Una cabecera de uno a cuatro bytes, construida como los enteros de longitud variable de QUIC, lleva la longitud decodificada, y la codificación más corta es obligatoria. El decodificador reserva memoria una sola vez, con exactitud, y trata un truncamiento como un error en lugar de como una respuesta corta plausible.
El compresor se niega. Una sonda rápida descarta los datos no repetitivos sin ejecutar ninguna búsqueda de coincidencias, y un umbral de un octavo decide el resto. Por debajo, el valor se guarda en crudo y compress devuelve false, porque leer un valor comprimido cuesta de cuatro a cinco veces más que leer uno almacenado. liblz4 no tiene ese paso.
saved >= 8 && saved * 8 >= original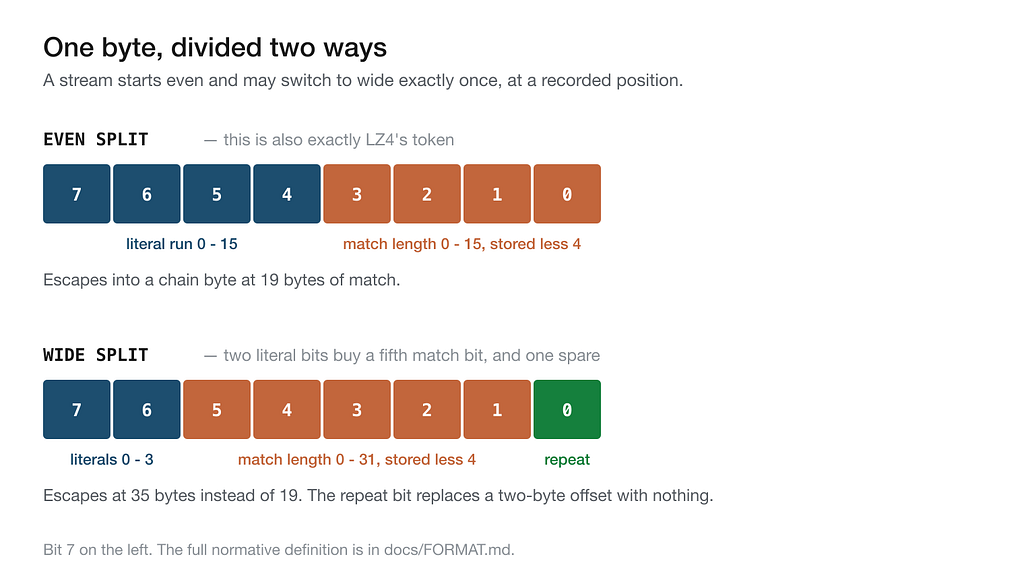
Por qué es rápido
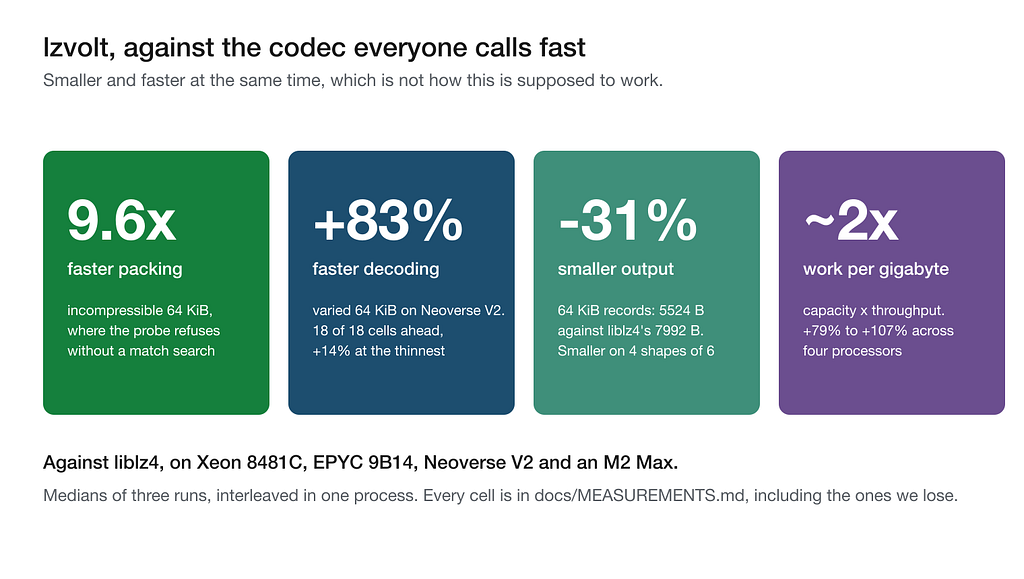
Un decodificador es un bucle sobre su entrada. Con registros de 64 KiB el mío recorre 5524 bytes donde liblz4 recorre 7992, para los mismos 65536 de salida. Dele a un bucle un 31 % menos de entrada y habrá hecho un 31 % menos de casi todo. La ganancia de tamaño y la de velocidad son un único resultado medido dos veces.
Tres mecanismos más. Un tercio de los bloques nunca carga un offset: 493 de 1567 llevan el indicador de repetición. Una sola carga de 32 bits trae token, offset y longitud de coincidencia cuando la secuencia de literales está vacía: el 56 % de los bloques en 4 KiB variados y el 88 % en registros de 64 KiB. Y por encima de un umbral, memcpy supera a un bucle escrito a mano, porque el de glibc lo afina gente que no hace otra cosa.
El kernel está limitado por la latencia, no por la emisión: el bucle de copia funciona a un IPC de 5,37 frente a un ancho de emisión de seis. Eliminar una instrucción no aporta nada; eliminar una carga dependiente de la cadena crítica aporta tres ciclos.
Una salvedad honesta: no he hecho ablación de estos mecanismos. Las cifras individuales están medidas; su orden de importancia es una inferencia, no una descomposición medida.
Las cifras, y lo que no afirmo
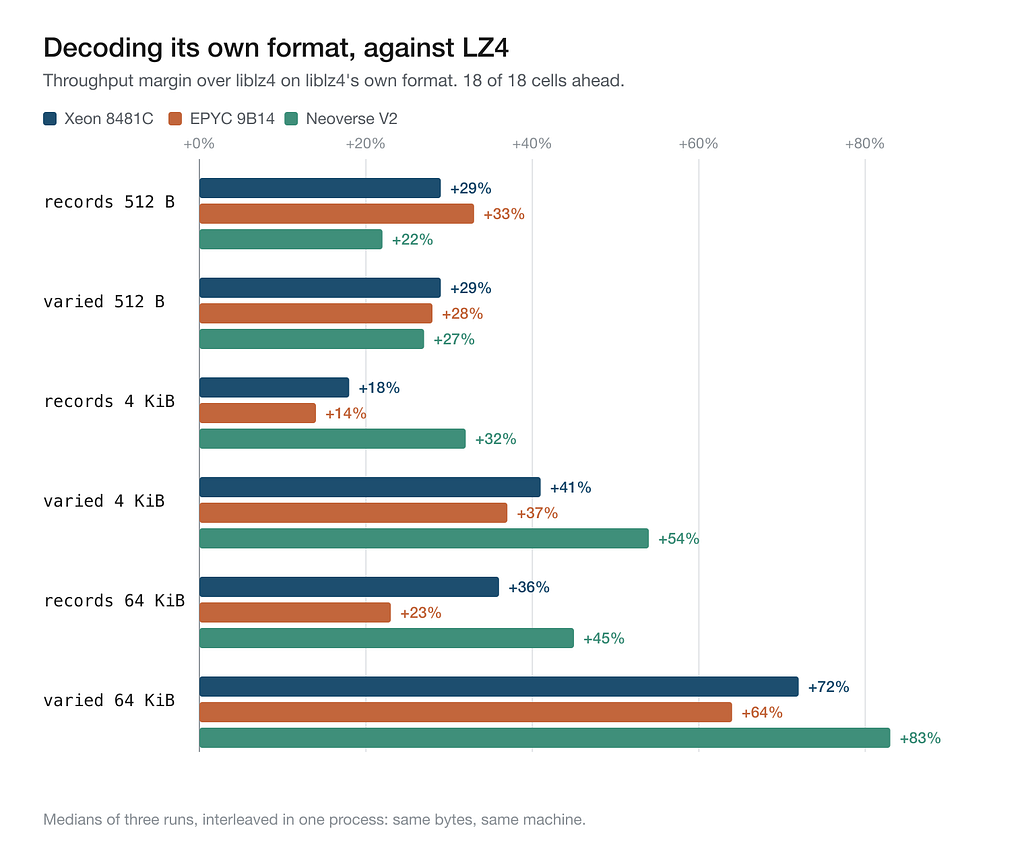
Tres máquinas, tres ejecuciones cada una, mediana de tres, intercaladas con liblz4 en un mismo proceso: mismos bytes, misma máquina, mismo minuto. Decodificando el formato nativo: dieciocho celdas, dieciocho victorias, de +14 % a +83 %. Leyendo los bloques propios de LZ4 gana 20 de 27; las siete derrotas se concentran en valores pequeños e incompresibles en x86, donde cedo un 12–15 %.
En tamaño, cuatro de seis perfiles son más pequeños que con LZ4 y dos más grandes: 64 KiB variados por un 1,4 % y registros de 512 bytes por un 1,6 %. liblz4 es el paquete estándar de la distribución, mientras que mi lado es ensamblador escrito a mano y seleccionado por línea de procesador: honesto para el despliegue, pero no una comparación de igual esfuerzo. No se controlaron el gobernador de CPU, el turbo ni el anclaje de núcleos, así que conviene desconfiar de los márgenes de un solo dígito.
El códec incluye cinco cuerpos de decodificador ensamblados por separado, porque cambios idénticos midieron signos opuestos en distintos procesadores: alinear el origen antes de la copia da +49 % en Neoverse V2 y −7,1 % en el M2 Max, ambos aarch64. Una cifra de benchmark sin nombre de máquina es ruido.
Medí contra liblz4 y lz4_flex; no contra Selkie de Oodle, lzturbo, Snappy, LZO ni zstd en niveles negativos. Así que, con precisión: en el formato que la industria estandarizó, en cuatro procesadores, LZ4 ya no es lo más rápido que lo lee. Eso es todo lo que respaldan las cifras.
Lo que los tests en verde no detectaron
Unos veinte cambios deliberados dieron un resultado nulo o negativo. Tres sostuvieron el proyecto, y los tres eliminaron trabajo en lugar de abaratar el trabajo existente.
El arnés de medición mintió cuatro veces, la última por aliasing de 4 KiB: mismo binario, un 32 % de diferencia, porque malloc colocaba los búferes de forma distinta en cada proceso. Ahora usa una sola arena con offsets fijos, toma la mediana de cinco ratios e imprime un umbral de resolución del 6 % por celda.
Tres bugs sobrevivieron a suites de tests en verde, entre ellos un decodificador que ejecutaba 512 bytes de su propia tabla de búsqueda como código máquina y una violación de procedencia que solo encontró Miri. Cada test partía de un flujo escrito por el compresor; un atacante no tiene esa restricción. Ahora los cambios en el ensamblador solo se aceptan después de que una corrupción deliberada ponga la suite en rojo, y cuatro objetivos de cargo-fuzz ejecutaron 115.090.390 iteraciones bajo AddressSanitizer sin fallos, lo que no es una prueba de ausencia.
La lección de fondo: cada problema tardío era una afirmación sobre el código que nadie había ejecutado. Ejecute la frase antes de escribirla.
Key Takeaways
lzvolt = "1.0" requiere rustc 1.85 o posterior, y la release incluye bibliotecas precompiladas .so, .dylib y .dll con cabecera C para Linux, macOS y Windows en amd64 y arm64. Windows ejecuta el Rust portable en lugar del ensamblador y es más lento; la API indica qué ruta le ha tocado.
Empiece con make quick: unos siete segundos, e imprime el nombre de su procesador y un veredicto. Después apunte lzvolt_decompress_lz4 a bloques que ya tenga, deje que liblz4 siga comprimiendo y compare. Nada recodificado, nada migrado: una tarde para descubrir si me equivoco. El formato tiene una especificación normativa y 16 vectores de prueba para decodificadores, y el registro de mediciones del repositorio contiene cada cifra y las veinte refutaciones.
Christian Schnapka
Macstab Engineering
Christian Schnapka construye las herramientas de ingeniería abiertas que hay detrás de Macstab. Publica las versiones extensas de estas investigaciones en Medium, con cada medición, cada salvedad y cada derrota incluidas.