Código-fonte no GitHub
O primeiro passo não custa nada
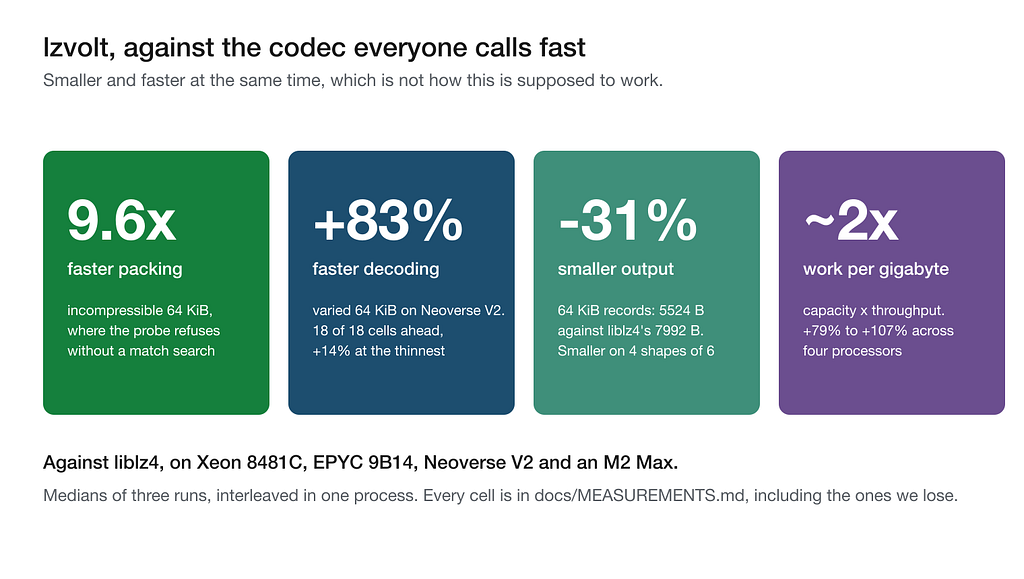
O lzvolt lê os blocos do próprio LZ4: não um formato parecido, mas exatamente os bytes que o liblz4 escreveu, de acordo com a especificação de blocos do LZ4. Em 20 de 27 perfis medidos, ele os lê mais rápido que o próprio liblz4.
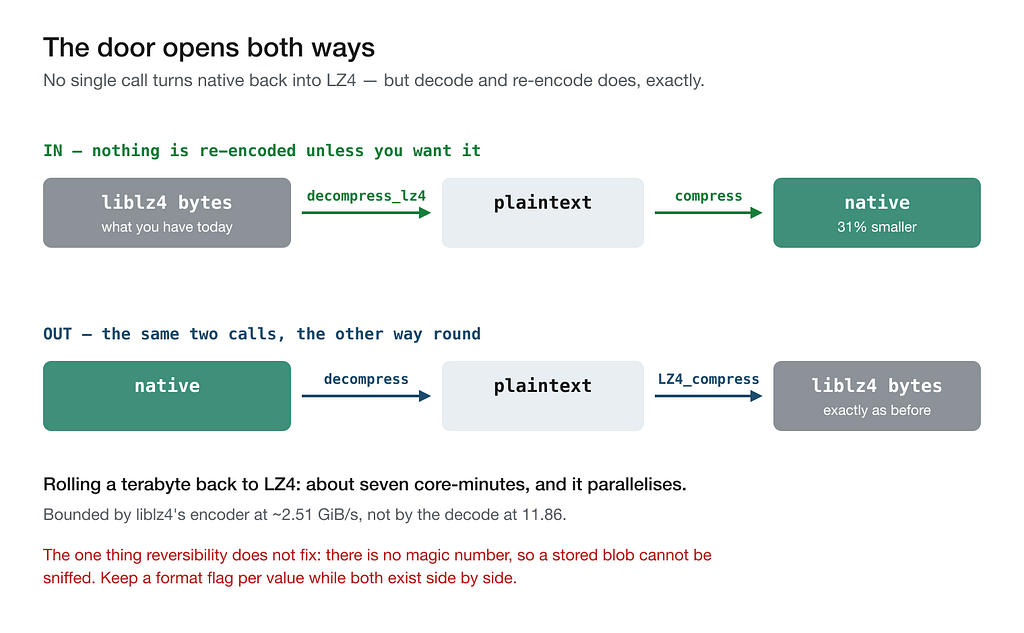
Portanto, a adoção mais barata é: manter o liblz4 como compressor, trocar o decodificador e parar por aí. LZ4_decompress_safe passa a ser lzvolt_decompress_lz4, com os mesmos argumentos. Os dados armazenados não se movem, o caminho de escrita fica intocado e não há nada a reverter, porque nada foi convertido. Para muitos sistemas esse é o lugar certo para ficar: decodifica-se mil vezes para cada escrita.
Recodificar para o formato nativo é um segundo passo, opcional. É aí que estão os 31% e o fator dois. E ele é reversível: decodificar com o novo, comprimir com o antigo. O caminho de volta é limitado pelo codificador do liblz4 — 2,51 GiB/s contra 11,86 —, de modo que um terabyte de dados lógicos volta atrás em cerca de sete minutos-núcleo.
Duas regras se você converter. Primeiro os leitores: um decodificador LZ4 rejeita corretamente um fluxo nativo, então uma única réplica não reiniciada estraga o dia. E enquanto os dois formatos coexistirem, mantenha um indicador por valor: propositalmente não existe número mágico, então um blob não pode ser identificado pelo conteúdo.
O que você ganha: dois ganhos que se multiplicam
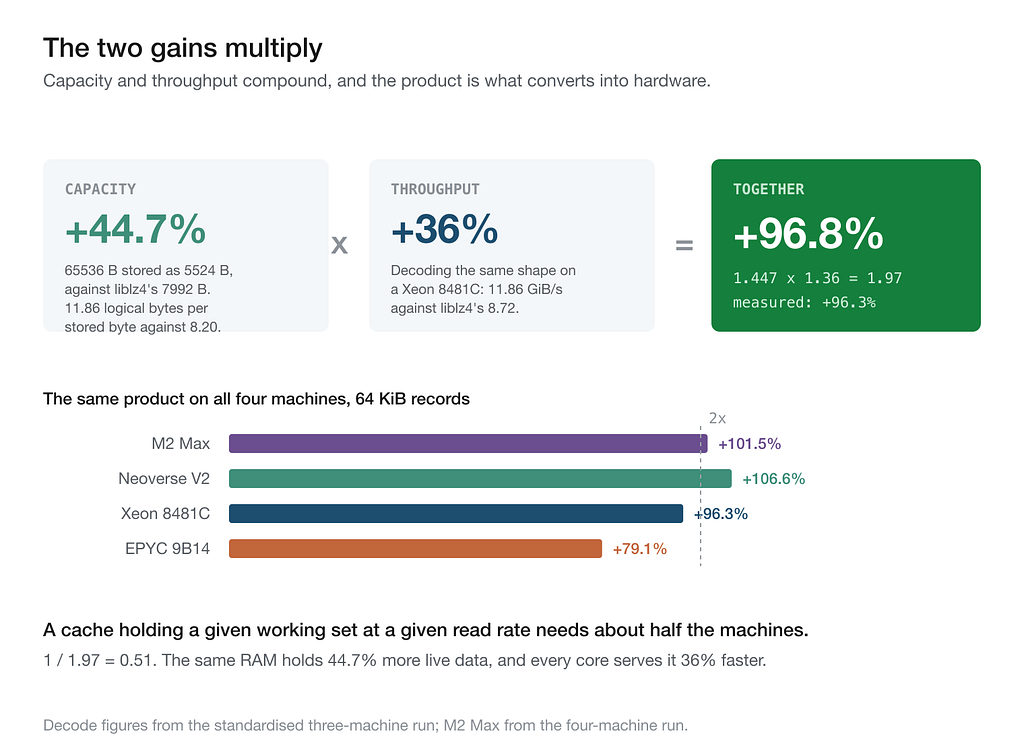
Capacidade e vazão se multiplicam em vez de se somarem: 44,7% mais dados ativos na mesma RAM e 36% mais rápido por núcleo. Em registros de 64 KiB, esse produto é +101,5% no M2 Max, +106,6% no Neoverse V2, +96,3% no Xeon e +79,1% no EPYC. Em termos de compras, um cache que mantém um dado working set a uma dada taxa de leitura precisa de cerca de metade das máquinas.
Isso também não se limita ao perfil que melhor comprime. Em dados variados de 64 KiB, a capacidade é 1,4% pior que a do LZ4, e a combinação ainda fica entre +62% e +89%, sustentada apenas pela decodificação.
Além disso, meus tamanhos incluem um cabeçalho de comprimento, enquanto os blocos crus do LZ4 não carregam comprimento algum. Um valor LZ4 independente significa o formato frame, que custa 23 bytes fixos. A única célula de registros que eu perco — 512 bytes, por 1,6% — eu ganho por 9,3% contra um valor LZ4 autocontido.
Como é feito: três decisões sobre bits
Nenhum algoritmo novo. LZ77 com as mesmas duas primitivas que todo mundo usa, sequências de literais e referências para trás, mais três decisões sobre como gastar bits que as implementações habituais não tomam.
Duas formas de token. O token do LZ4 é um byte: quatro bits de comprimento de literais, quatro de comprimento de correspondência. Em registros variados de 4 KiB, 49% dos comprimentos de correspondência ficam abaixo do teto de quatro bits e 47% acima — exatamente em cima da linha, de modo que o branch decisivo muda de direção o tempo todo e o preditor é inútil. Por isso o formato tem dois layouts, e um fluxo pode alternar entre eles exatamente uma vez. O layout largo troca dois bits de literais por um quinto bit de correspondência, levando o escape de 19 para 35 bytes, mais um bit para um indicador de repetição: o mesmo offset da última vez.
O comprimento vive no fluxo. Um cabeçalho de um a quatro bytes, construído como os inteiros de comprimento variável do QUIC, carrega o comprimento decodificado, e a codificação mais curta é obrigatória. O decodificador aloca uma única vez, com exatidão, e trata um truncamento como erro em vez de uma resposta curta plausível.
O compressor recusa. Uma sondagem rápida descarta dados não repetitivos sem executar nenhuma busca de correspondências, e um limiar de um oitavo decide o resto. Abaixo dele, o valor é armazenado cru e compress retorna false, porque ler um valor comprimido custa de quatro a cinco vezes mais do que ler um valor armazenado. O liblz4 não tem essa etapa.
saved >= 8 && saved * 8 >= original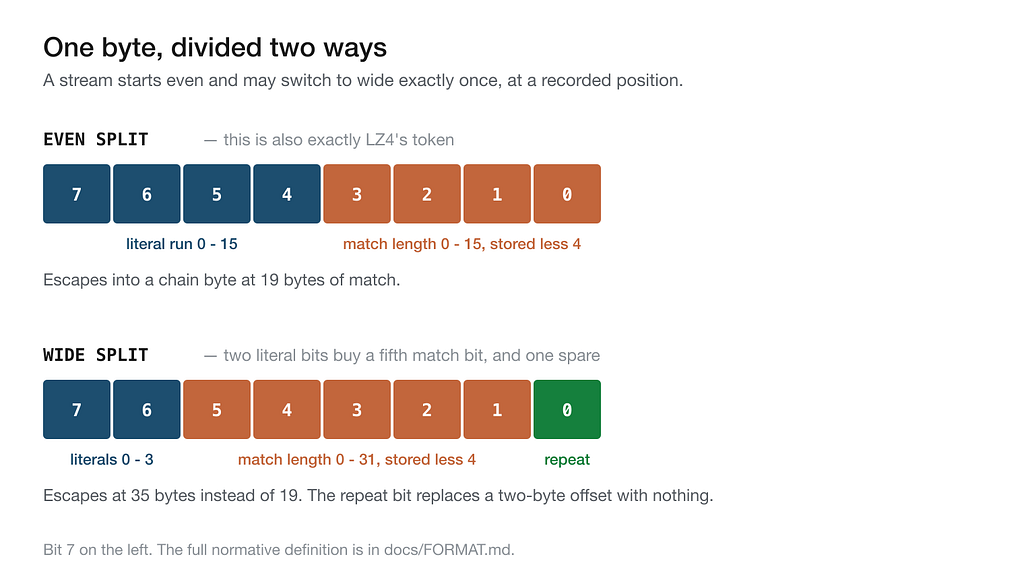
Por que é rápido
Um decodificador é um laço sobre sua entrada. Em registros de 64 KiB, o meu percorre 5524 bytes onde o liblz4 percorre 7992, para os mesmos 65536 de saída. Dê a um laço 31% menos entrada e você terá feito 31% menos de quase tudo. O ganho de tamanho e o ganho de velocidade são um único resultado medido duas vezes.
Mais três mecanismos. Um terço dos blocos nunca carrega um offset: 493 de 1567 levam o indicador de repetição. Um único load de 32 bits traz token, offset e comprimento de correspondência quando a sequência de literais está vazia: 56% dos blocos em 4 KiB variados, 88% em registros de 64 KiB. E acima de um limiar, o memcpy supera um laço escrito à mão, porque o da glibc é ajustado por pessoas que não fazem outra coisa.
O kernel é limitado pela latência, não pela emissão: o laço de cópia roda a um IPC de 5,37 contra uma largura de emissão de seis. Remover uma instrução não rende nada; remover um load dependente da cadeia crítica rende três ciclos.
Uma ressalva honesta: não fiz ablação desses mecanismos. Os números individuais são medidos; a ordem de importância entre eles é uma inferência, não uma decomposição medida.
Os números, e o que eu não afirmo
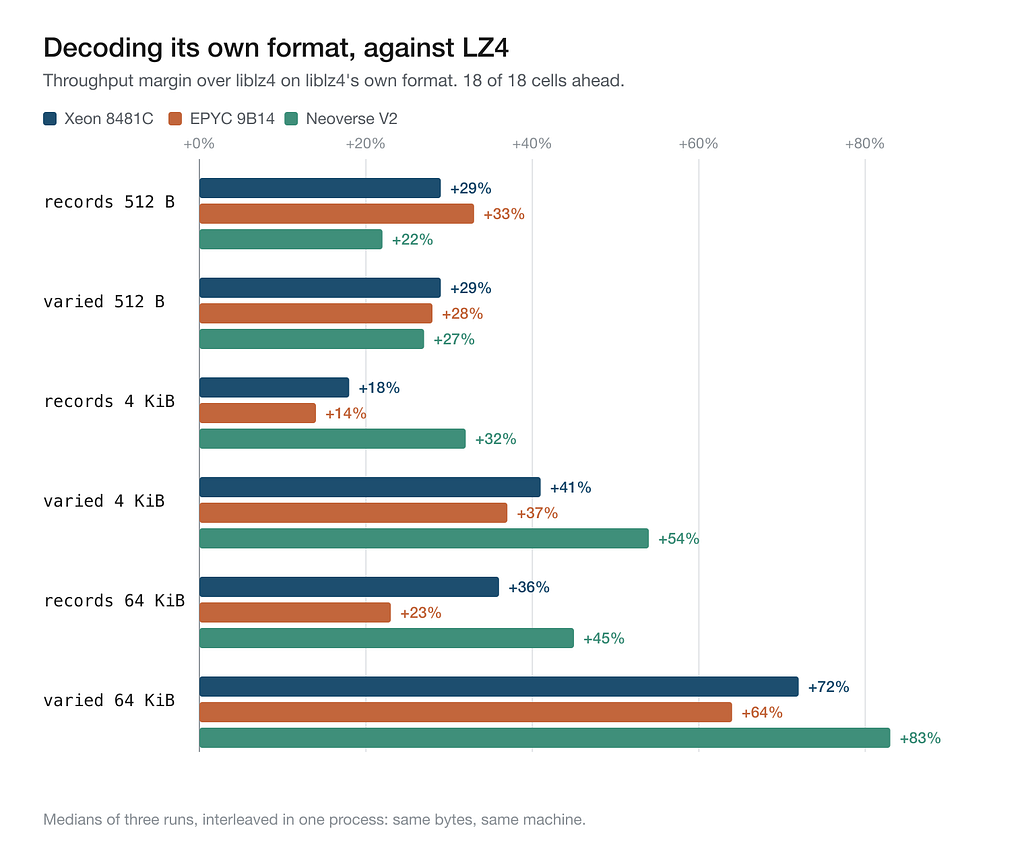
Três máquinas, três execuções cada, mediana de três, intercaladas com o liblz4 em um único processo — mesmos bytes, mesma máquina, mesmo minuto. Decodificando o formato nativo: dezoito células, dezoito vitórias, de +14% a +83%. Lendo os blocos do próprio LZ4, vence 20 de 27; as sete derrotas se concentram em valores pequenos e incompressíveis no x86, onde cedo 12–15%.
Em tamanho, quatro de seis perfis são menores que com o LZ4 e dois são maiores: 64 KiB variados por 1,4%, registros de 512 bytes por 1,6%. O liblz4 é o pacote padrão da distribuição, enquanto do meu lado há assembly escrito à mão e selecionado por linha de processador — honesto para implantação, mas não uma comparação de esforço equivalente. Governador da CPU, turbo e fixação de núcleos não foram controlados, então trate margens de um dígito com desconfiança.
O codec traz cinco corpos de decodificador montados separadamente, porque mudanças idênticas mediram sinais opostos em processadores diferentes: alinhar a origem antes da cópia dá +49% no Neoverse V2 e −7,1% no M2 Max, ambos aarch64. Um número de benchmark sem o nome da máquina é ruído.
Medi contra o liblz4 e o lz4_flex — não contra o Selkie da Oodle, lzturbo, Snappy, LZO ou zstd em níveis negativos. Então, com precisão: no formato que a indústria padronizou, em quatro processadores, o LZ4 não é mais o que o lê mais rápido. É tudo o que os números sustentam.
O que os testes verdes não encontraram
Cerca de vinte mudanças deliberadas deram resultado nulo ou negativo. Três sustentaram o projeto, e todas as três eliminaram trabalho em vez de baratear o trabalho existente.
O harness de medição mentiu quatro vezes, a última por aliasing de 4 KiB: mesmo binário, 32% de diferença, porque o malloc posicionava os buffers de forma diferente em cada processo. Agora ele usa uma única arena com offsets fixos, toma a mediana de cinco razões e imprime um limite de resolução de 6% por célula.
Três bugs sobreviveram a suítes de testes verdes, entre eles um decodificador que executava 512 bytes da própria tabela de consulta como código de máquina e uma violação de proveniência que só o Miri encontrou. Todo teste começava de um fluxo escrito pelo compressor; um atacante não tem essa restrição. Agora mudanças no assembly só são aceitas depois que uma corrupção deliberada deixa a suíte vermelha, e quatro alvos de cargo-fuzz rodaram 115.090.390 execuções sob AddressSanitizer sem falhas — o que não é prova de ausência.
A lição de fundo: cada problema tardio era uma afirmação sobre o código que ninguém havia executado. Execute a frase antes de escrevê-la.
Key Takeaways
lzvolt = "1.0" requer rustc 1.85 ou mais recente, e a release traz bibliotecas pré-compiladas .so, .dylib e .dll com cabeçalho C para Linux, macOS e Windows em amd64 e arm64. O Windows roda o Rust portável em vez do assembly e é mais lento; a API informa qual caminho você recebeu.
Comece com make quick: cerca de sete segundos, e ele imprime o nome do seu processador e um veredito. Depois aponte lzvolt_decompress_lz4 para blocos que você já tem, deixe o liblz4 comprimindo e compare. Nada recodificado, nada migrado — uma tarde para descobrir se estou errado. O formato tem uma especificação normativa e 16 vetores de teste para decodificadores, e o registro de medições no repositório contém cada número e todas as vinte refutações.
Christian Schnapka
Macstab Engineering
Christian Schnapka constrói as ferramentas de engenharia abertas por trás da Macstab. Ele publica as versões completas destas investigações no Medium, com cada medição, cada ressalva e cada derrota incluídas.