Codice sorgente su GitHub
Il primo passo non costa nulla
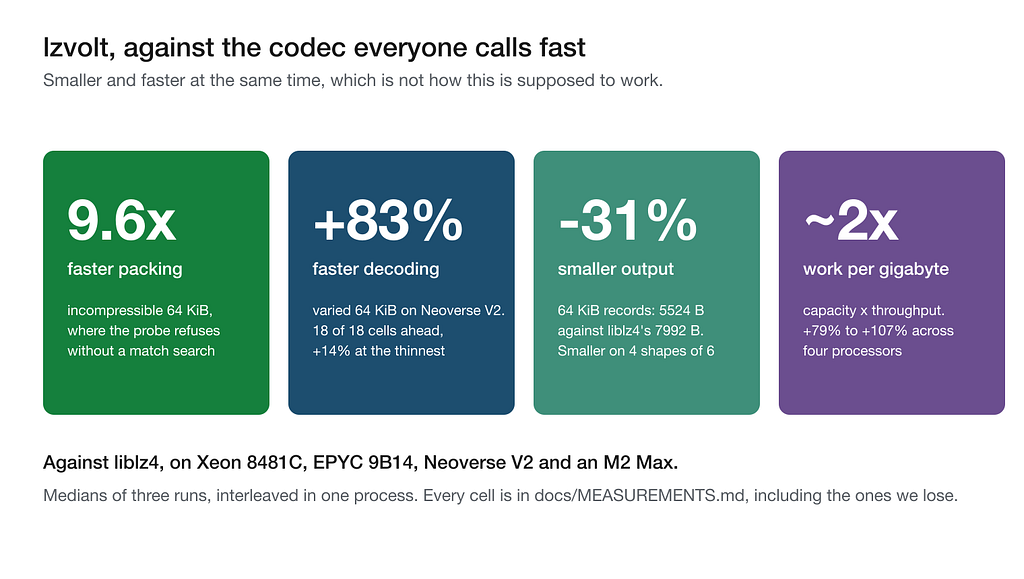
lzvolt legge i blocchi propri di LZ4: non un formato simile, ma esattamente i byte scritti da liblz4, secondo la specifica dei blocchi LZ4. Su 20 dei 27 profili misurati li legge più velocemente di liblz4 stesso.
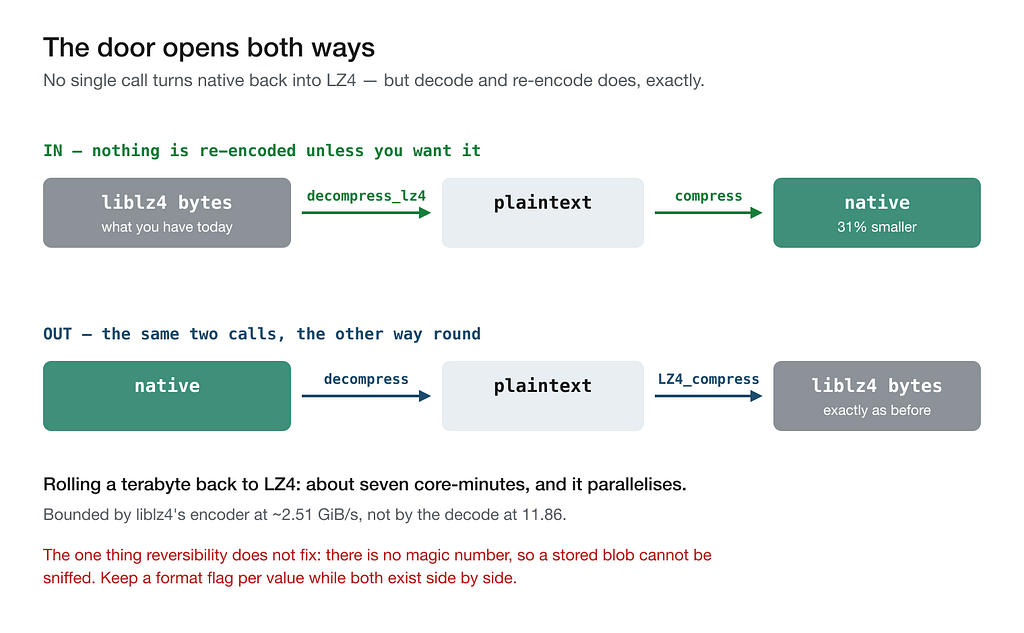
L'adozione più economica è quindi: tenere liblz4 come compressore, cambiare il decoder, fermarsi. LZ4_decompress_safe diventa lzvolt_decompress_lz4, con gli stessi argomenti. I dati memorizzati non si spostano, il percorso di scrittura resta intatto e non c'è nulla da annullare, perché nulla è stato convertito. Per molti sistemi è il posto giusto in cui restare: si decodifica mille volte per ogni scrittura.
La ricodifica nel formato nativo è un secondo passo, facoltativo. È lì che stanno il 31% e il fattore due. Ed è reversibile: decodificare con il nuovo, comprimere con il vecchio. Il percorso di ritorno è limitato dall'encoder di liblz4 — 2,51 GiB/s contro 11,86 — quindi un terabyte di dati logici torna indietro in circa sette minuti-core.
Due regole se convertite. Prima i lettori: un decoder LZ4 rifiuta correttamente uno stream nativo, quindi una sola replica non riavviata rovina la giornata. E finché i due formati convivono, tenete un flag per ogni valore: volutamente non esiste un magic number, quindi un blob non può essere riconosciuto dal contenuto.
Cosa ottenete: due guadagni che si moltiplicano
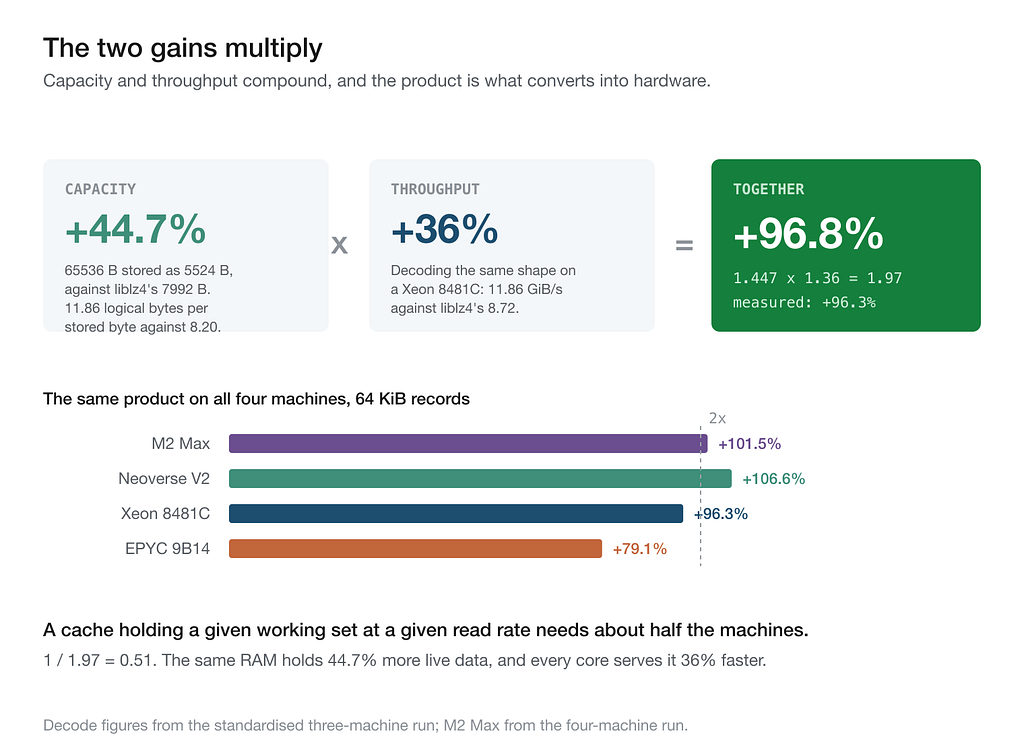
Capacità e throughput si moltiplicano invece di sommarsi: il 44,7% di dati attivi in più nella stessa RAM e il 36% più veloce per core. Su record da 64 KiB il prodotto è +101,5% sull'M2 Max, +106,6% su Neoverse V2, +96,3% su Xeon e +79,1% su EPYC. In termini di acquisti, una cache che mantiene un dato working set a un dato ritmo di lettura ha bisogno di circa la metà delle macchine.
Non si limita nemmeno al profilo più comprimibile. Su dati variati da 64 KiB la capacità è dell'1,4% peggiore rispetto a LZ4, e la combinazione resta comunque tra +62% e +89%, sostenuta dalla sola decodifica.
Inoltre le mie dimensioni includono un header di lunghezza, mentre i blocchi nudi di LZ4 non portano alcuna lunghezza. Un valore LZ4 autonomo significa il formato frame, che costa 23 byte fissi. L'unica cella di record che perdo — 512 byte, dell'1,6% — la vinco del 9,3% contro un valore LZ4 autosufficiente.
Come funziona: tre decisioni sui bit
Nessun nuovo algoritmo. LZ77 con le stesse due primitive che usano tutti, sequenze di letterali e riferimenti all'indietro, più tre decisioni su come spendere i bit che le implementazioni consuete non prendono.
Due forme di token. Il token di LZ4 è un byte: quattro bit di lunghezza dei letterali, quattro di lunghezza del match. Su record variati da 4 KiB, il 49% delle lunghezze di match cade sotto il limite dei quattro bit e il 47% sopra, a cavallo, così il branch decisivo cambia continuamente direzione e il predittore è inutile. Il formato prevede quindi due layout, e uno stream può passare dall'uno all'altro esattamente una volta. Il layout largo scambia due bit di letterali con un quinto bit di match, spostando l'escape da 19 a 35 byte, più un bit per un flag di ripetizione: stesso offset dell'ultima volta.
La lunghezza vive nello stream. Un header da uno a quattro byte, costruito come gli interi a lunghezza variabile di QUIC, porta la lunghezza decodificata, e la codifica più corta è obbligatoria. Il decoder alloca una sola volta, esattamente, e tratta un troncamento come un errore invece che come una risposta breve plausibile.
Il compressore rifiuta. Una sonda rapida scarta i dati non ripetitivi senza eseguire alcuna ricerca di match, e una soglia di un ottavo decide il resto. Al di sotto, il valore viene memorizzato grezzo e compress restituisce false, perché leggere un valore compresso costa da quattro a cinque volte più che leggerne uno memorizzato. liblz4 non ha questo passaggio.
saved >= 8 && saved * 8 >= original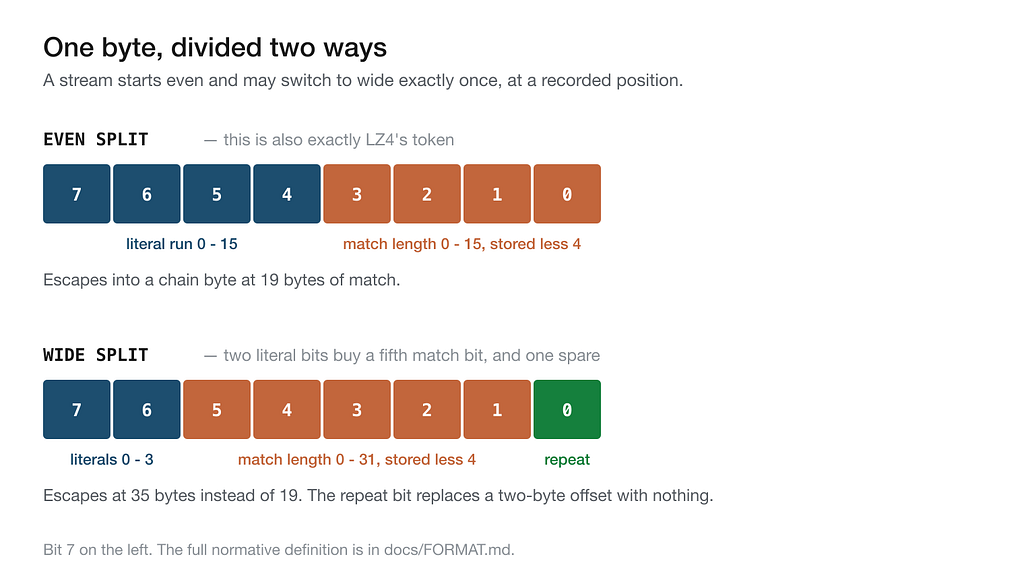
Perché è veloce
Un decoder è un ciclo sul proprio input. Su record da 64 KiB il mio percorre 5524 byte dove liblz4 ne percorre 7992, per gli stessi 65536 in uscita. Date a un ciclo il 31% di input in meno e avrete fatto il 31% in meno di quasi tutto. Il guadagno di dimensione e quello di velocità sono un unico risultato misurato due volte.
Altri tre meccanismi. Un terzo dei blocchi non carica mai un offset: 493 su 1567 portano il flag di ripetizione. Un unico load a 32 bit fornisce token, offset e lunghezza del match quando la sequenza di letterali è vuota: il 56% dei blocchi su 4 KiB variati, l'88% su record da 64 KiB. E sopra una certa soglia memcpy batte un ciclo scritto a mano, perché quello di glibc è ottimizzato da persone che non fanno altro.
Il kernel è limitato dalla latenza, non dall'issue: il ciclo di copia gira a un IPC di 5,37 contro un'ampiezza di issue di sei. Eliminare un'istruzione non porta nulla; eliminare un load dipendente dalla catena critica fa guadagnare tre cicli.
Una riserva onesta: non ho fatto un'ablazione di questi meccanismi. I singoli numeri sono misurati; la loro classifica è un'inferenza, non una scomposizione misurata.
I numeri, e cosa non affermo
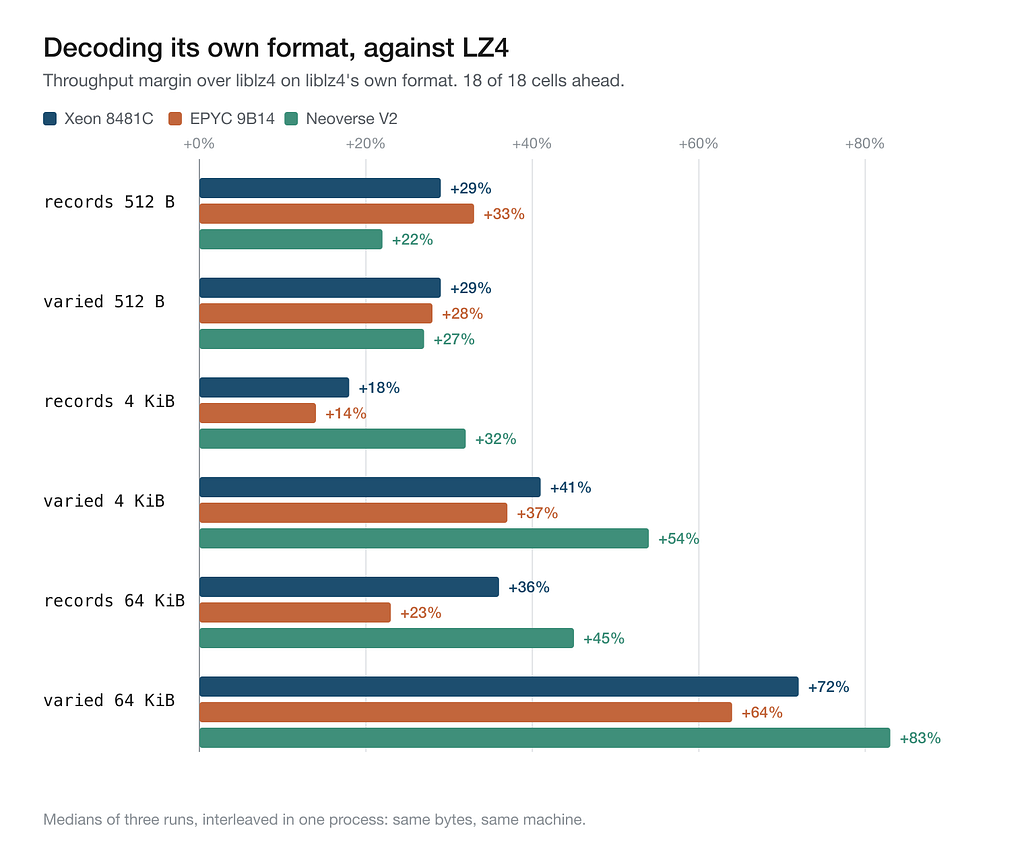
Tre macchine, tre esecuzioni ciascuna, mediana di tre, interlacciate con liblz4 in un unico processo: stessi byte, stessa macchina, stesso minuto. Decodifica del formato nativo: diciotto celle, diciotto vittorie, da +14% a +83%. Nella lettura dei blocchi propri di LZ4 vince 20 su 27; le sette sconfitte si concentrano su valori piccoli e incomprimibili su x86, dove cedo il 12–15%.
Per le dimensioni, quattro profili su sei sono più piccoli che con LZ4 e due più grandi: 64 KiB variati dell'1,4%, record da 512 byte dell'1,6%. liblz4 è il pacchetto standard della distribuzione, mentre dalla mia parte c'è assembly scritto a mano e selezionato per linea di processore: onesto per il deployment, ma non un confronto a parità di sforzo. Governor della CPU, turbo e pinning dei core non sono stati controllati, quindi i margini a una cifra vanno trattati con sospetto.
Il codec include cinque corpi di decoder assemblati separatamente, perché modifiche identiche hanno dato segni opposti su processori diversi: allineare la sorgente prima della copia vale +49% su Neoverse V2 e −7,1% sull'M2 Max, entrambi aarch64. Un numero di benchmark senza il nome della macchina è rumore.
Ho misurato contro liblz4 e lz4_flex, non contro Selkie di Oodle, lzturbo, Snappy, LZO o zstd ai livelli negativi. Quindi, con precisione: sul formato che l'industria ha standardizzato, su quattro processori, LZ4 non è più la cosa più veloce che lo legge. È tutto ciò che i numeri sostengono.
Cosa non hanno trovato i test verdi
Circa venti modifiche deliberate hanno dato un risultato nullo o negativo. Tre hanno sostenuto il progetto, e tutte e tre hanno eliminato lavoro invece di rendere più economico il lavoro esistente.
L'harness di misura ha mentito quattro volte, l'ultima a causa dell'aliasing a 4 KiB: stesso binario, 32% di differenza, perché malloc posizionava i buffer in modo diverso in ogni processo. Ora usa un'unica arena a offset fissi, prende la mediana di cinque rapporti e stampa una soglia di risoluzione del 6% per cella.
Tre bug sono sopravvissuti a suite di test verdi, tra cui un decoder che eseguiva 512 byte della propria tabella di lookup come codice macchina e una violazione di provenance trovata solo da Miri. Ogni test partiva da uno stream scritto dal compressore; un attaccante non ha questo vincolo. Ora le modifiche all'assembly vengono accettate solo dopo che una corruzione deliberata ha fatto diventare rossa la suite, e quattro target cargo-fuzz hanno eseguito 115.090.390 esecuzioni sotto AddressSanitizer senza crash, il che non è una prova di assenza.
La lezione di fondo: ogni problema emerso alla fine era un'affermazione sul codice che nessuno aveva eseguito. Eseguite la frase prima di scriverla.
Key Takeaways
lzvolt = "1.0" richiede rustc 1.85 o successivo, e la release include librerie precompilate .so, .dylib e .dll con header C per Linux, macOS e Windows su amd64 e arm64. Windows esegue il Rust portabile invece dell'assembly ed è più lento; l'API indica quale percorso state usando.
Iniziate con make quick: circa sette secondi, e stampa il nome del vostro processore e un verdetto. Poi puntate lzvolt_decompress_lz4 su blocchi che avete già, lasciate comprimere liblz4 e confrontate. Nulla ricodificato, nulla migrato: un pomeriggio per scoprire se ho torto. Il formato ha una specifica normativa e 16 vettori di test per decoder, e il registro delle misurazioni nel repository contiene ogni numero e tutte le venti confutazioni.
Christian Schnapka
Macstab Engineering
Christian Schnapka costruisce gli strumenti di ingegneria aperti dietro Macstab. Pubblica le versioni estese di queste indagini su Medium, con ogni misurazione, ogni riserva e ogni sconfitta incluse.