Code source sur GitHub
La première étape ne coûte rien
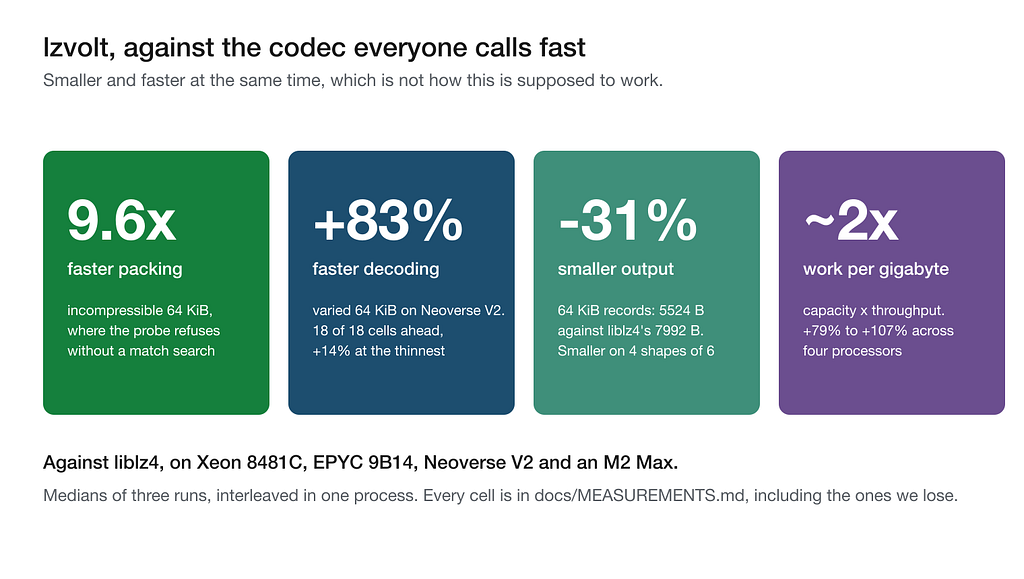
lzvolt lit les blocs propres à LZ4 — pas un format similaire, mais les octets mêmes écrits par liblz4, conformément à la spécification des blocs LZ4. Sur 20 des 27 profils mesurés, il les lit plus vite que liblz4.
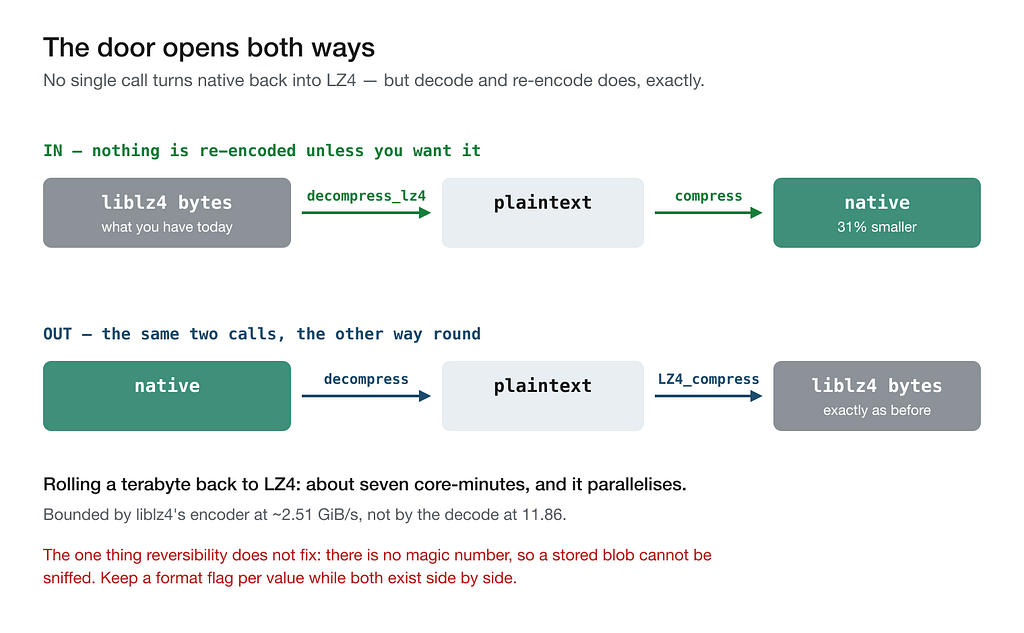
L'adoption la moins chère est donc : garder liblz4 comme compresseur, changer de décodeur, et s'arrêter là. LZ4_decompress_safe devient lzvolt_decompress_lz4, avec les mêmes arguments. Les données stockées ne bougent pas, le chemin d'écriture reste intact, et il n'y a rien à annuler puisque rien n'a été converti. Pour beaucoup de systèmes, c'est le bon endroit où rester — on décode mille fois pour une écriture.
Le réencodage dans le format natif est une seconde étape, optionnelle. C'est là que se trouvent les 31 % et le facteur deux. Et elle est réversible : décoder avec le nouveau, compresser avec l'ancien. L'aller-retour est limité par l'encodeur de liblz4 — 2,51 Gio/s contre 11,86 —, si bien qu'un téraoctet de données logiques revient en arrière en environ sept minutes-cœur.
Deux règles si vous convertissez. Les lecteurs d'abord : un décodeur LZ4 rejette correctement un flux natif, donc une seule réplique non redémarrée gâche la journée. Et tant que les deux formats coexistent, conservez un indicateur par valeur — il n'y a délibérément aucun nombre magique, un blob ne peut donc pas être identifié par son contenu.
Ce que vous obtenez : deux gains qui se multiplient
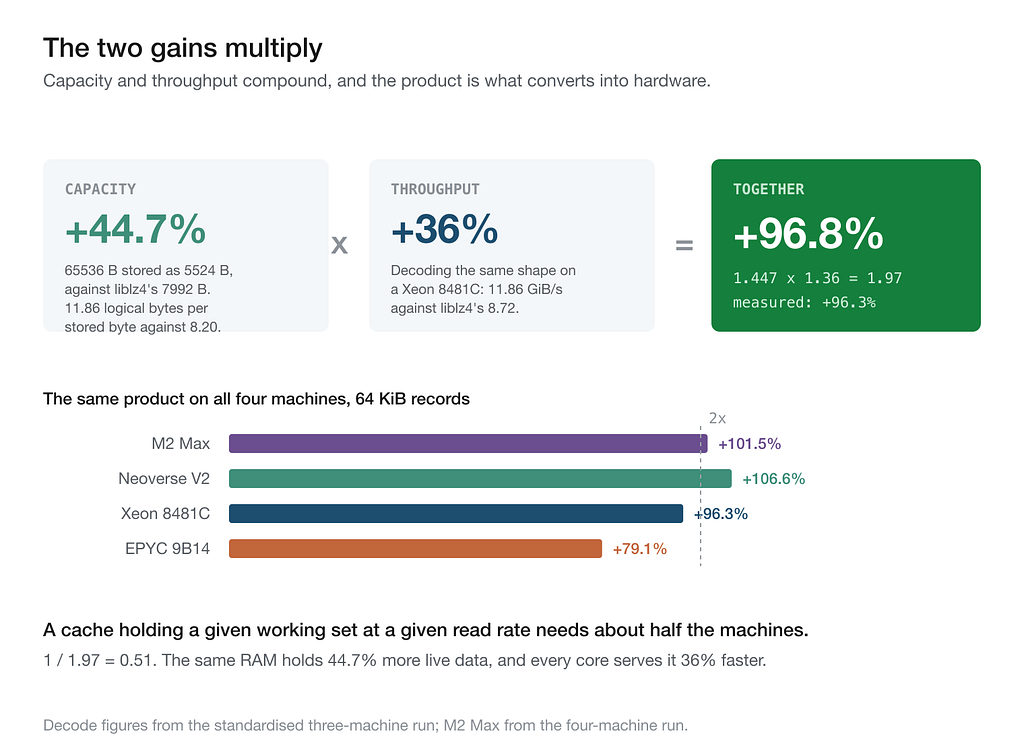
Capacité et débit se multiplient au lieu de s'additionner : 44,7 % de données actives en plus dans la même RAM et 36 % plus rapide par cœur. Sur des enregistrements de 64 Kio, ce produit atteint +101,5 % sur le M2 Max, +106,6 % sur Neoverse V2, +96,3 % sur Xeon et +79,1 % sur EPYC. En termes d'achats, un cache qui tient un working set donné à un débit de lecture donné a besoin d'environ deux fois moins de machines.
Ce n'est pas réservé au profil le plus compressible. Sur des données variées de 64 Kio, la capacité est inférieure de 1,4 % à celle de LZ4, et la combinaison reste à +62 % à +89 %, portée par le seul décodage.
De plus, mes tailles incluent un en-tête de longueur, alors que les blocs bruts de LZ4 ne portent aucune longueur. Une valeur LZ4 autonome implique le format frame, qui coûte 23 octets fixes. La seule cellule d'enregistrements que je perds — 512 octets, de 1,6 % — je la gagne de 9,3 % face à une valeur LZ4 autonome.
Comment ça marche : trois décisions sur les bits
Pas de nouvel algorithme. Du LZ77 avec les deux mêmes primitives que tout le monde — séquences de littéraux et références arrière —, plus trois décisions sur la dépense des bits que les implémentations habituelles ne prennent pas.
Deux formes de jeton. Le jeton de LZ4 tient sur un octet : quatre bits de longueur de littéraux, quatre de longueur de correspondance. Sur des enregistrements variés de 4 Kio, 49 % des longueurs de correspondance tombent sous le plafond de quatre bits et 47 % au-dessus — à cheval, si bien que la branche décisive change sans cesse de direction et que le prédicteur est inutile. Le format comporte donc deux dispositions, et un flux peut basculer de l'une à l'autre exactement une fois. La disposition large échange deux bits de littéraux contre un cinquième bit de correspondance, repoussant l'échappement de 19 à 35 octets, plus un bit pour un drapeau de répétition : même offset que la dernière fois.
La longueur vit dans le flux. Un en-tête d'un à quatre octets, construit comme les entiers à longueur variable de QUIC, porte la longueur décodée, et l'encodage le plus court est obligatoire. Le décodeur alloue une seule fois, exactement, et traite une troncature comme une erreur plutôt que comme une réponse courte plausible.
Le compresseur refuse. Une sonde rapide écarte les données non répétitives sans lancer de recherche de correspondances, et un seuil d'un huitième tranche le reste. En dessous, la valeur est stockée brute et compress renvoie false, car lire une valeur compressée coûte quatre à cinq fois plus que lire une valeur stockée. liblz4 n'a pas cette étape.
saved >= 8 && saved * 8 >= original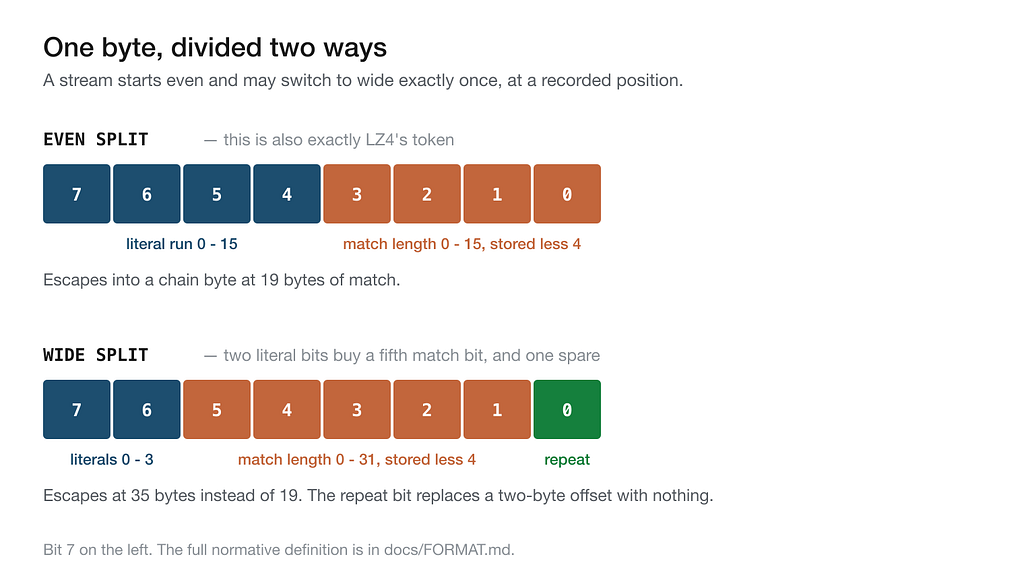
Pourquoi c'est rapide
Un décodeur est une boucle sur son entrée. Sur des enregistrements de 64 Kio, le mien parcourt 5524 octets là où liblz4 en parcourt 7992, pour les mêmes 65536 en sortie. Donnez à une boucle 31 % d'entrée en moins et vous aurez fait 31 % de moins de presque tout. Le gain de taille et le gain de vitesse sont un seul résultat mesuré deux fois.
Trois autres mécanismes. Un tiers des blocs ne charge jamais d'offset — 493 sur 1567 portent le drapeau de répétition. Un seul chargement 32 bits fournit jeton, offset et longueur de correspondance lorsque la séquence de littéraux est vide : 56 % des blocs sur 4 Kio variés, 88 % sur des enregistrements de 64 Kio. Et au-delà d'un seuil, memcpy bat une boucle écrite à la main, car celui de glibc est optimisé par des gens qui ne font que ça.
Le noyau est limité par la latence, pas par l'émission : la boucle de copie tourne à un IPC de 5,37 pour une largeur d'émission de six. Supprimer une instruction ne rapporte rien ; supprimer un chargement dépendant de la chaîne critique rapporte trois cycles.
Une réserve honnête : je n'ai pas fait d'ablation de ces mécanismes. Les chiffres individuels sont mesurés ; leur classement est une déduction, pas une décomposition mesurée.
Les chiffres, et ce que je ne prétends pas
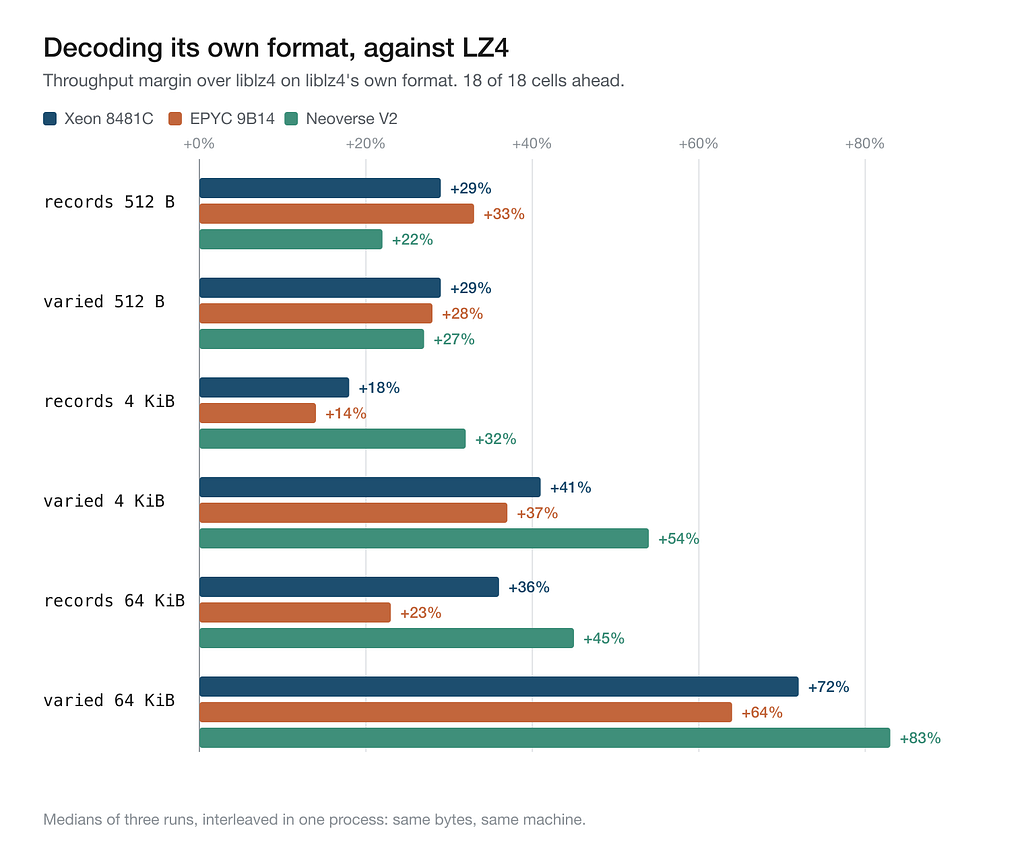
Trois machines, trois exécutions chacune, médiane de trois, entrelacées avec liblz4 dans un seul processus — mêmes octets, même machine, même minute. Décodage du format natif : dix-huit cellules, dix-huit victoires, de +14 % à +83 %. La lecture des blocs propres à LZ4 l'emporte sur 20 des 27 ; les sept défaites se concentrent sur de petites valeurs incompressibles sur x86, où je cède 12 à 15 %.
En taille, quatre profils sur six sont plus petits qu'avec LZ4 et deux plus grands : 64 Kio variés de 1,4 %, enregistrements de 512 octets de 1,6 %. liblz4 est le paquet standard de la distribution, tandis que mon côté est de l'assembleur écrit à la main et sélectionné par gamme de processeur — honnête pour le déploiement, mais pas une comparaison à effort égal. Le gouverneur CPU, le turbo et l'épinglage des cœurs n'étaient pas contrôlés ; méfiez-vous donc des écarts à un chiffre.
Le codec embarque cinq corps de décodeur assemblés séparément, car des modifications identiques ont donné des signes opposés selon les processeurs : aligner la source avant la copie donne +49 % sur Neoverse V2 et −7,1 % sur le M2 Max, tous deux aarch64. Un chiffre de benchmark sans nom de machine, c'est du bruit.
J'ai mesuré contre liblz4 et lz4_flex — pas contre Selkie d'Oodle, lzturbo, Snappy, LZO ni zstd aux niveaux négatifs. Donc, précisément : sur le format que l'industrie a standardisé, sur quatre processeurs, LZ4 n'est plus ce qui le lit le plus vite. C'est tout ce que les chiffres soutiennent.
Ce que les tests au vert n'ont pas trouvé
Une vingtaine de modifications délibérées ont donné un résultat nul ou négatif. Trois ont porté le projet, et toutes trois ont supprimé du travail au lieu de rendre moins cher le travail existant.
Le banc de mesure a menti quatre fois, la dernière par aliasing de 4 Kio : même binaire, 32 % d'écart, parce que malloc plaçait les tampons différemment à chaque processus. Il utilise désormais une seule arène à offsets fixes, prend la médiane de cinq ratios et affiche un seuil de résolution de 6 % par cellule.
Trois bugs ont survécu à des suites de tests au vert, dont un décodeur qui exécutait 512 octets de sa propre table de correspondance comme code machine, et une violation de provenance que seul Miri a trouvée. Chaque test partait d'un flux écrit par le compresseur ; un attaquant n'a pas cette contrainte. Désormais, une modification de l'assembleur n'est acceptée qu'après qu'une corruption délibérée a fait passer la suite au rouge, et quatre cibles cargo-fuzz ont tourné 115 090 390 exécutions sous AddressSanitizer sans plantage — ce qui n'est pas une preuve d'absence.
La leçon de fond : chaque problème tardif était une affirmation sur le code que personne n'avait exécutée. Exécutez la phrase avant de l'écrire.
Key Takeaways
lzvolt = "1.0" nécessite rustc 1.85 ou plus récent, et la release fournit des bibliothèques précompilées .so, .dylib et .dll avec un en-tête C pour Linux, macOS et Windows sur amd64 et arm64. Windows exécute le Rust portable au lieu de l'assembleur et est plus lent ; l'API indique quel chemin vous avez obtenu.
Commencez par make quick : environ sept secondes, et il affiche le nom de votre processeur et un verdict. Pointez ensuite lzvolt_decompress_lz4 vers des blocs que vous avez déjà, laissez liblz4 compresser, et comparez. Rien de réencodé, rien de migré — un après-midi pour découvrir si je me trompe. Le format dispose d'une spécification normative et de 16 vecteurs de test pour décodeur, et le journal de mesures du dépôt contient chaque chiffre et les vingt réfutations.
Christian Schnapka
Macstab Engineering
Christian Schnapka conçoit les outils d'ingénierie ouverts derrière Macstab. Il publie les versions longues de ces enquêtes sur Medium — chaque mesure, chaque réserve et chaque défaite incluses.