Quellcode auf GitHub
Schritt eins kostet nichts
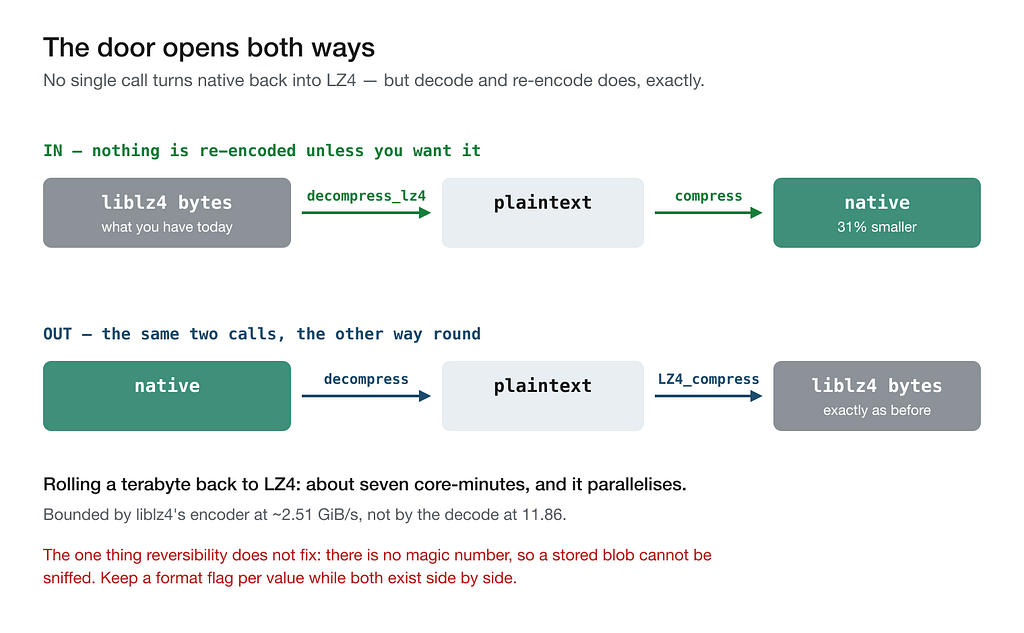
lzvolt liest die eigenen Blöcke von LZ4 – kein ähnliches Format, sondern genau die Bytes, die liblz4 geschrieben hat, gemäß der LZ4-Block-Spezifikation. Bei 20 von 27 gemessenen Datenformen liest es sie schneller als liblz4 selbst.
Die günstigste Einführung lautet also: liblz4 als Packer behalten, den Decoder tauschen, fertig. Aus LZ4_decompress_safe wird lzvolt_decompress_lz4, mit denselben Argumenten. Gespeicherte Daten bewegen sich nicht, der Schreibpfad bleibt unberührt, und es gibt nichts zurückzurollen, weil nichts konvertiert wurde. Für viele Systeme ist das der richtige Ort, um zu bleiben – dekodiert wird tausendmal pro Schreibvorgang.
Das Neukodieren ins native Format ist ein zweiter, optionaler Schritt. Dort liegen die 31 % und der Faktor zwei. Und er ist umkehrbar: mit dem neuen dekodieren, mit dem alten packen. Der Rückweg wird vom Encoder von liblz4 begrenzt – 2,51 GiB/s gegenüber 11,86 –, sodass ein Terabyte logischer Daten in etwa sieben Kern-Minuten zurückgerollt ist.
Zwei Regeln, falls Sie konvertieren. Zuerst die Leser: Ein LZ4-Decoder weist einen nativen Stream korrekt zurück, eine einzige nicht neu gestartete Replica verdirbt also den Tag. Und solange beide Formate nebeneinander existieren, führen Sie pro Wert ein Flag – es gibt bewusst keine Magic Number, ein Blob lässt sich also nicht am Inhalt erkennen.
Was Sie bekommen: zwei Gewinne, die sich multiplizieren
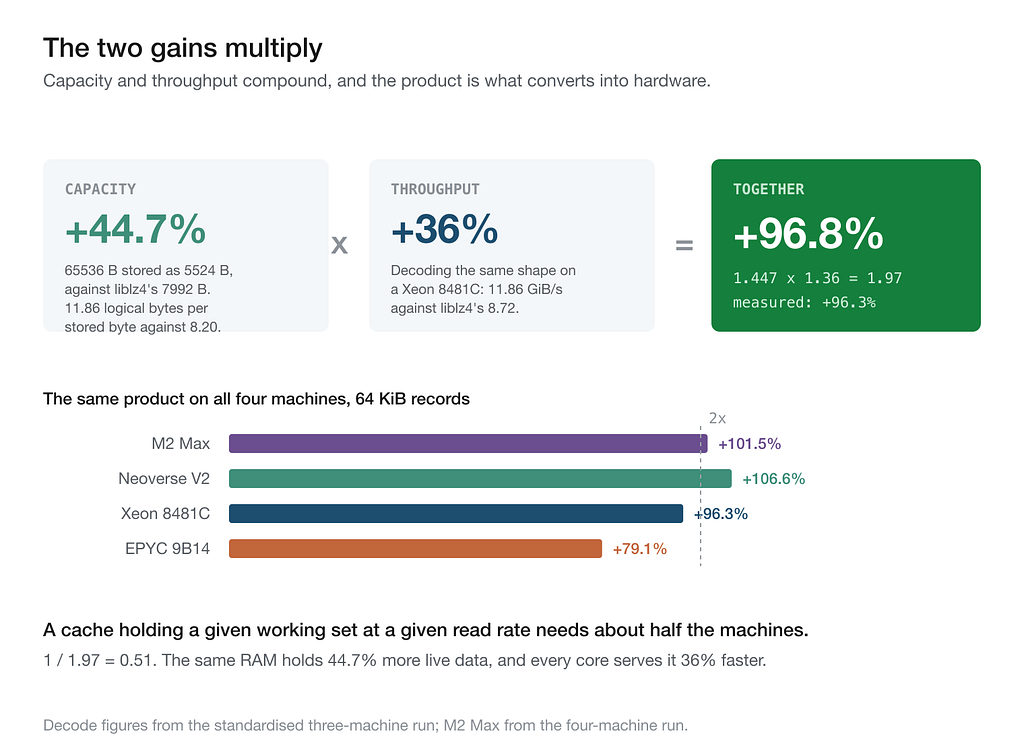
Kapazität und Durchsatz multiplizieren sich, statt sich zu addieren: 44,7 % mehr Live-Daten im selben RAM und 36 % schneller pro Kern. Auf 64-KiB-Records ergibt das Produkt +101,5 % auf dem M2 Max, +106,6 % auf Neoverse V2, +96,3 % auf Xeon und +79,1 % auf EPYC. Im Einkauf heißt das: Ein Cache, der ein bestimmtes Working Set bei einer bestimmten Leserate hält, braucht etwa halb so viele Maschinen.
Das beschränkt sich auch nicht auf die am besten komprimierbare Datenform. Bei variierten 64-KiB-Daten ist die Kapazität 1,4 % schlechter als bei LZ4, und die Kombination liegt trotzdem bei +62 % bis +89 %, getragen allein vom Dekodieren.
Außerdem enthalten meine Größen einen Längen-Header, während die nackten Blöcke von LZ4 überhaupt keine Länge tragen. Ein eigenständiger LZ4-Wert bedeutet das Frame-Format, und das kostet pauschal 23 Bytes. Die eine Record-Zelle, die ich verliere – 512 Bytes, um 1,6 % –, gewinne ich gegen einen in sich geschlossenen LZ4-Wert um 9,3 %.
Wie es funktioniert: drei Entscheidungen über Bits
Kein neuer Algorithmus. LZ77 mit denselben zwei Primitiven, die alle verwenden – Literal-Runs und Rückverweise –, plus drei Entscheidungen darüber, wie Bits ausgegeben werden, die die üblichen Implementierungen nicht treffen.
Zwei Token-Formen. Das Token von LZ4 ist ein Byte: vier Bits Literal-Run-Länge, vier Bits Match-Länge. Bei variierten 4-KiB-Records liegen 49 % der Match-Längen unter der Vier-Bit-Grenze und 47 % darüber – genau rittlings darauf, sodass der entscheidende Branch ständig die Richtung wechselt und der Predictor nutzlos ist. Das Format kennt daher zwei Layouts, und ein Stream darf genau einmal zwischen ihnen wechseln. Das breite Layout tauscht zwei Literal-Bits gegen ein fünftes Match-Bit, verschiebt den Escape von 19 auf 35 Bytes und gewinnt ein Bit für ein Repeat-Flag: derselbe Offset wie beim letzten Mal.
Die Länge steckt im Stream. Ein Header von ein bis vier Bytes, aufgebaut wie die Variable-Length-Integers von QUIC, trägt die dekodierte Länge, und die kürzeste Kodierung ist Pflicht. Der Decoder alloziert einmal und exakt und behandelt eine Kürzung als Fehler statt als plausible kurze Antwort.
Der Packer verweigert. Eine schnelle Probe überspringt nicht-repetitive Daten, ohne eine Match-Suche zu starten, und eine Schwelle von einem Achtel entscheidet den Rest. Darunter wird der Wert roh gespeichert und compress liefert false, denn das Lesen eines gepackten Werts kostet vier- bis fünfmal so viel wie das Lesen eines gespeicherten. liblz4 hat keinen solchen Schritt.
saved >= 8 && saved * 8 >= original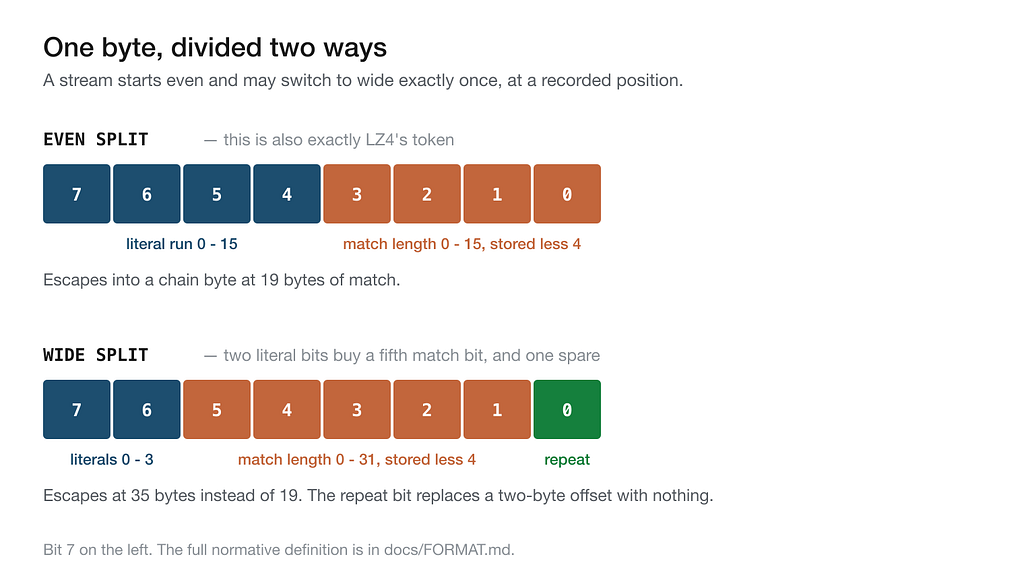
Warum es schnell ist
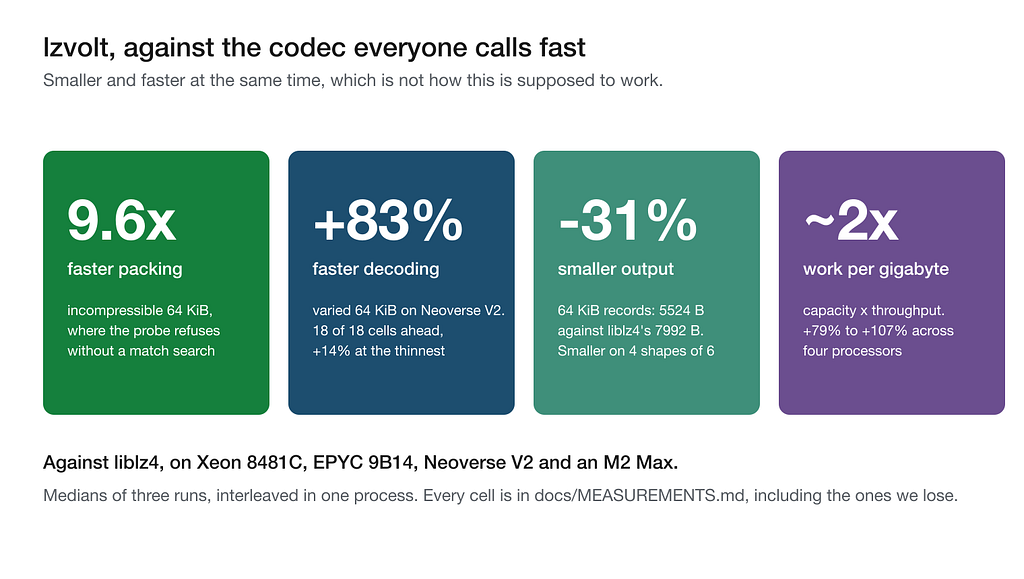
Ein Decoder ist eine Schleife über seine Eingabe. Auf 64-KiB-Records durchläuft meiner 5524 Bytes, wo liblz4 7992 durchläuft, für dieselben 65536 Bytes Ausgabe. Gibt man einer Schleife 31 % weniger Eingabe, hat man 31 % weniger von fast allem getan. Der Größengewinn und der Geschwindigkeitsgewinn sind ein einziges Ergebnis, zweimal gemessen.
Drei weitere Mechanismen. Ein Drittel der Blöcke lädt nie einen Offset – 493 von 1567 tragen das Repeat-Flag. Ein einziger 32-Bit-Load liefert Token, Offset und Match-Länge, wenn der Literal-Run leer ist: bei 56 % der Blöcke auf variierten 4 KiB, bei 88 % auf 64-KiB-Records. Und oberhalb einer Schwelle schlägt memcpy eine handgeschriebene Schleife, weil die von glibc von Leuten getunt wird, die nichts anderes tun.
Der Kernel ist latenzgebunden, nicht issue-gebunden: Die Kopierschleife läuft mit einer IPC von 5,37 bei einer Issue-Breite von sechs. Eine Instruktion zu streichen bringt nichts; einen abhängigen Load aus der kritischen Kette zu streichen bringt drei Zyklen.
Ein ehrlicher Vorbehalt: Ich habe diese Mechanismen nicht einzeln abgeschaltet und gemessen. Die einzelnen Zahlen sind gemessen; ihre Rangfolge ist eine Schlussfolgerung, keine gemessene Zerlegung.
Die Zahlen – und was ich nicht behaupte
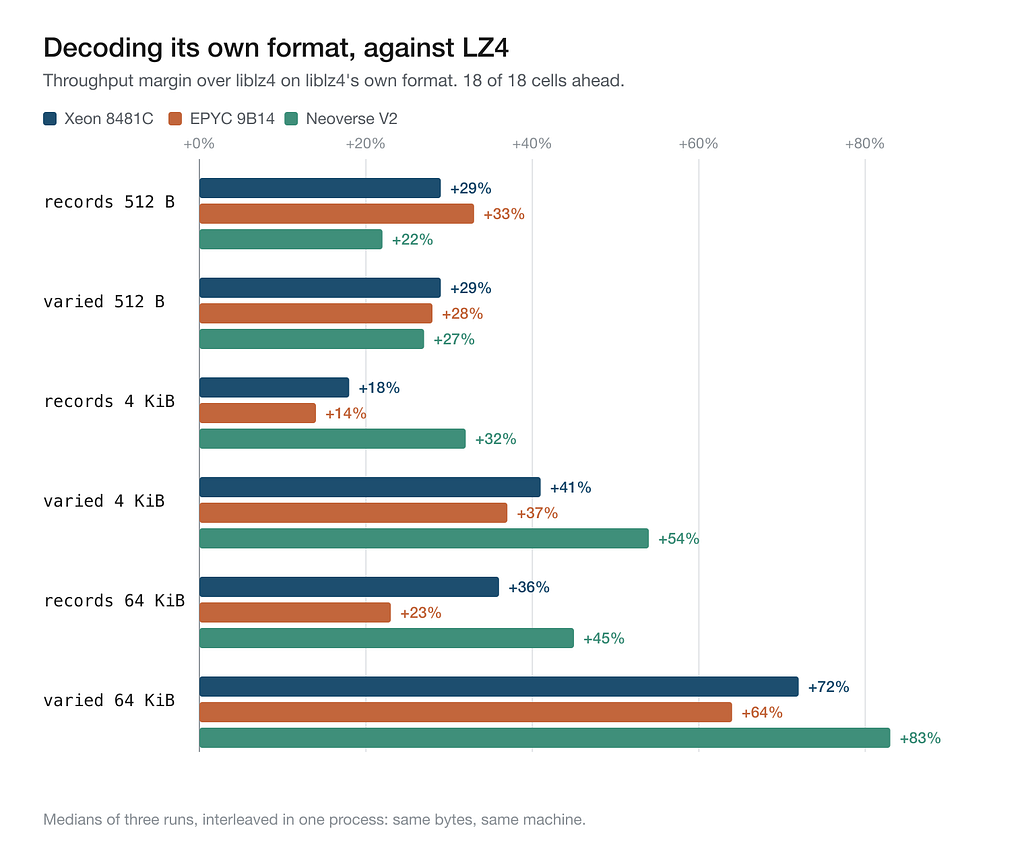
Drei Maschinen, je drei Läufe, Median aus drei, verschränkt gegen liblz4 in einem Prozess – dieselben Bytes, dieselbe Maschine, dieselbe Minute. Dekodieren des nativen Formats: achtzehn Zellen, achtzehn Siege, +14 % bis +83 %. Beim Lesen der eigenen Blöcke von LZ4 gewinnt es 20 von 27; die sieben Niederlagen häufen sich bei kleinen, nicht komprimierbaren Werten auf x86, wo ich 12–15 % abgebe.
Bei der Größe sind vier von sechs Datenformen kleiner als bei LZ4 und zwei größer: variierte 64 KiB um 1,4 %, 512-Byte-Records um 1,6 %. liblz4 ist das Standardpaket der Distribution, während meine Seite handgeschriebenes Assembly ist, das pro Prozessorlinie ausgewählt wird – ehrlich für den Einsatz, aber kein Vergleich gleichen Aufwands. CPU-Governor, Turbo und Core-Pinning wurden nicht kontrolliert; einstellige Abstände sollten Sie also mit Misstrauen betrachten.
Der Codec liefert fünf separat assemblierte Decoder-Körper aus, weil identische Änderungen auf verschiedenen Prozessoren mit entgegengesetztem Vorzeichen gemessen wurden: Die Quelle vor dem Kopieren auszurichten bringt +49 % auf Neoverse V2 und −7,1 % auf dem M2 Max, beide aarch64. Eine Benchmark-Zahl ohne Maschinennamen ist Rauschen.
Gemessen habe ich gegen liblz4 und lz4_flex – nicht gegen Oodles Selkie, lzturbo, Snappy, LZO oder zstd auf negativen Stufen. Präzise formuliert also: Für das Format, auf das sich die Branche geeinigt hat, ist LZ4 auf vier Prozessoren nicht mehr das Schnellste, was es lesen kann. Mehr stützen die Zahlen nicht.
Was grüne Tests nicht gefunden haben
Rund zwanzig bewusste Änderungen ergaben null oder ein negatives Ergebnis. Drei haben das Projekt getragen, und alle drei haben Arbeit gestrichen, statt vorhandene Arbeit billiger zu machen.
Das Mess-Harness hat viermal gelogen, zuletzt durch 4-KiB-Aliasing: dasselbe Binary, 32 % Unterschied, weil malloc die Puffer in jedem Prozess anders platzierte. Heute nutzt es eine Arena mit festen Offsets, nimmt den Median aus fünf Verhältnissen und gibt pro Zelle eine Auflösungsgrenze von 6 % aus.
Drei Bugs haben grüne Testsuiten überlebt, darunter ein Decoder, der 512 Bytes seiner eigenen Lookup-Tabelle als Maschinencode ausführte, und eine Provenance-Verletzung, die nur Miri gefunden hat. Jeder Test begann mit einem Stream, den der Packer geschrieben hatte; ein Angreifer kennt diese Einschränkung nicht. Änderungen am Assembly werden jetzt nur akzeptiert, nachdem eine absichtliche Beschädigung die Suite rot gefärbt hat, und vier cargo-fuzz-Targets liefen 115.090.390 Ausführungen unter AddressSanitizer ohne Absturz – kein Beweis der Abwesenheit.
Die eigentliche Lehre: Jedes späte Problem war eine Behauptung über den Code, die niemand ausgeführt hatte. Führen Sie den Satz aus, bevor Sie ihn aufschreiben.
Key Takeaways
lzvolt = "1.0" benötigt rustc 1.85 oder neuer, und das Release enthält vorgebaute .so-, .dylib- und .dll-Bibliotheken mit C-Header für Linux, macOS und Windows auf amd64 und arm64. Windows nutzt statt des Assembly das portable Rust und ist langsamer; die API meldet, welchen Pfad Sie bekommen haben.
Beginnen Sie mit make quick: etwa sieben Sekunden, und es gibt den Namen Ihres Prozessors und ein Urteil aus. Richten Sie dann lzvolt_decompress_lz4 auf Blöcke, die Sie bereits haben, lassen Sie liblz4 weiter packen, und vergleichen Sie. Nichts neu kodiert, nichts migriert – ein Nachmittag, um herauszufinden, ob ich falschliege. Das Format hat eine normative Spezifikation und 16 Decoder-Testvektoren, und das Messprotokoll im Repository enthält jede Zahl und alle zwanzig Widerlegungen.
Christian Schnapka
Macstab Engineering
Christian Schnapka baut die offenen Engineering-Werkzeuge hinter Macstab. Die Langfassungen dieser Untersuchungen veröffentlicht er auf Medium – jede Messung, jeder Vorbehalt und jede Niederlage inklusive.